Workshop zur verantwortungsbewussten Nutzung von Daten für Grundmodelle
Beschreibung
Da Grundmodelle immer größer werden, sind verfügbare Trainingsdatenquellen schnell erschöpft. Dennoch sind mehrere Formen wertvoller Datenartefakte, wie medizinische Aufzeichnungen, rechtliche und finanzielle Dokumente, aufgrund ihrer sensiblen Natur von der Nutzung im Modelltraining ausgeschlossen. Darüber hinaus haben die starken Fähigkeit zur Argumentation in aktuellen generativen Modellen die Möglichkeit eröffnet, hochgradig personalisierte KI-Anwendungen zu schaffen, doch diese sind durch den begrenzten Zugang zu qualitativ hochwertigen Benutzerdaten blockiert. Daher ist es von immensem Wert, diese Datenquellen verantwortungsbewusst zu erschließen (zum Beispiel: durch Datenumwandlung oder eingeschränkte Trainingsparadigmen) oder synthetische Alternativen zu generieren. In diesem Workshop wollen wir Fachleute aus den Bereichen Daten, Datenschutz, Modelltraining und rechtliche Richtlinien zusammenbringen, um die Grenzen der verantwortungsbewussten Nutzung solcher sensibler Daten mit Grundmodellen voranzutreiben.
Veranstaltungsort
Lassen Sie Ihr Netzwerk wissen, dass Sie dabei sind
Teilen Sie diese Veranstaltung, um Gespräche zu beginnen, Kollegen einzuladen und sich vorab zu vernetzen.
Die Referenten kennenlernen
Sewon Min
Thema:UC Berkeley
Alex Dimakis
Thema:UC Berkeley, Bespoke Labs
Nouha Dziri
Thema:Cohere Labs
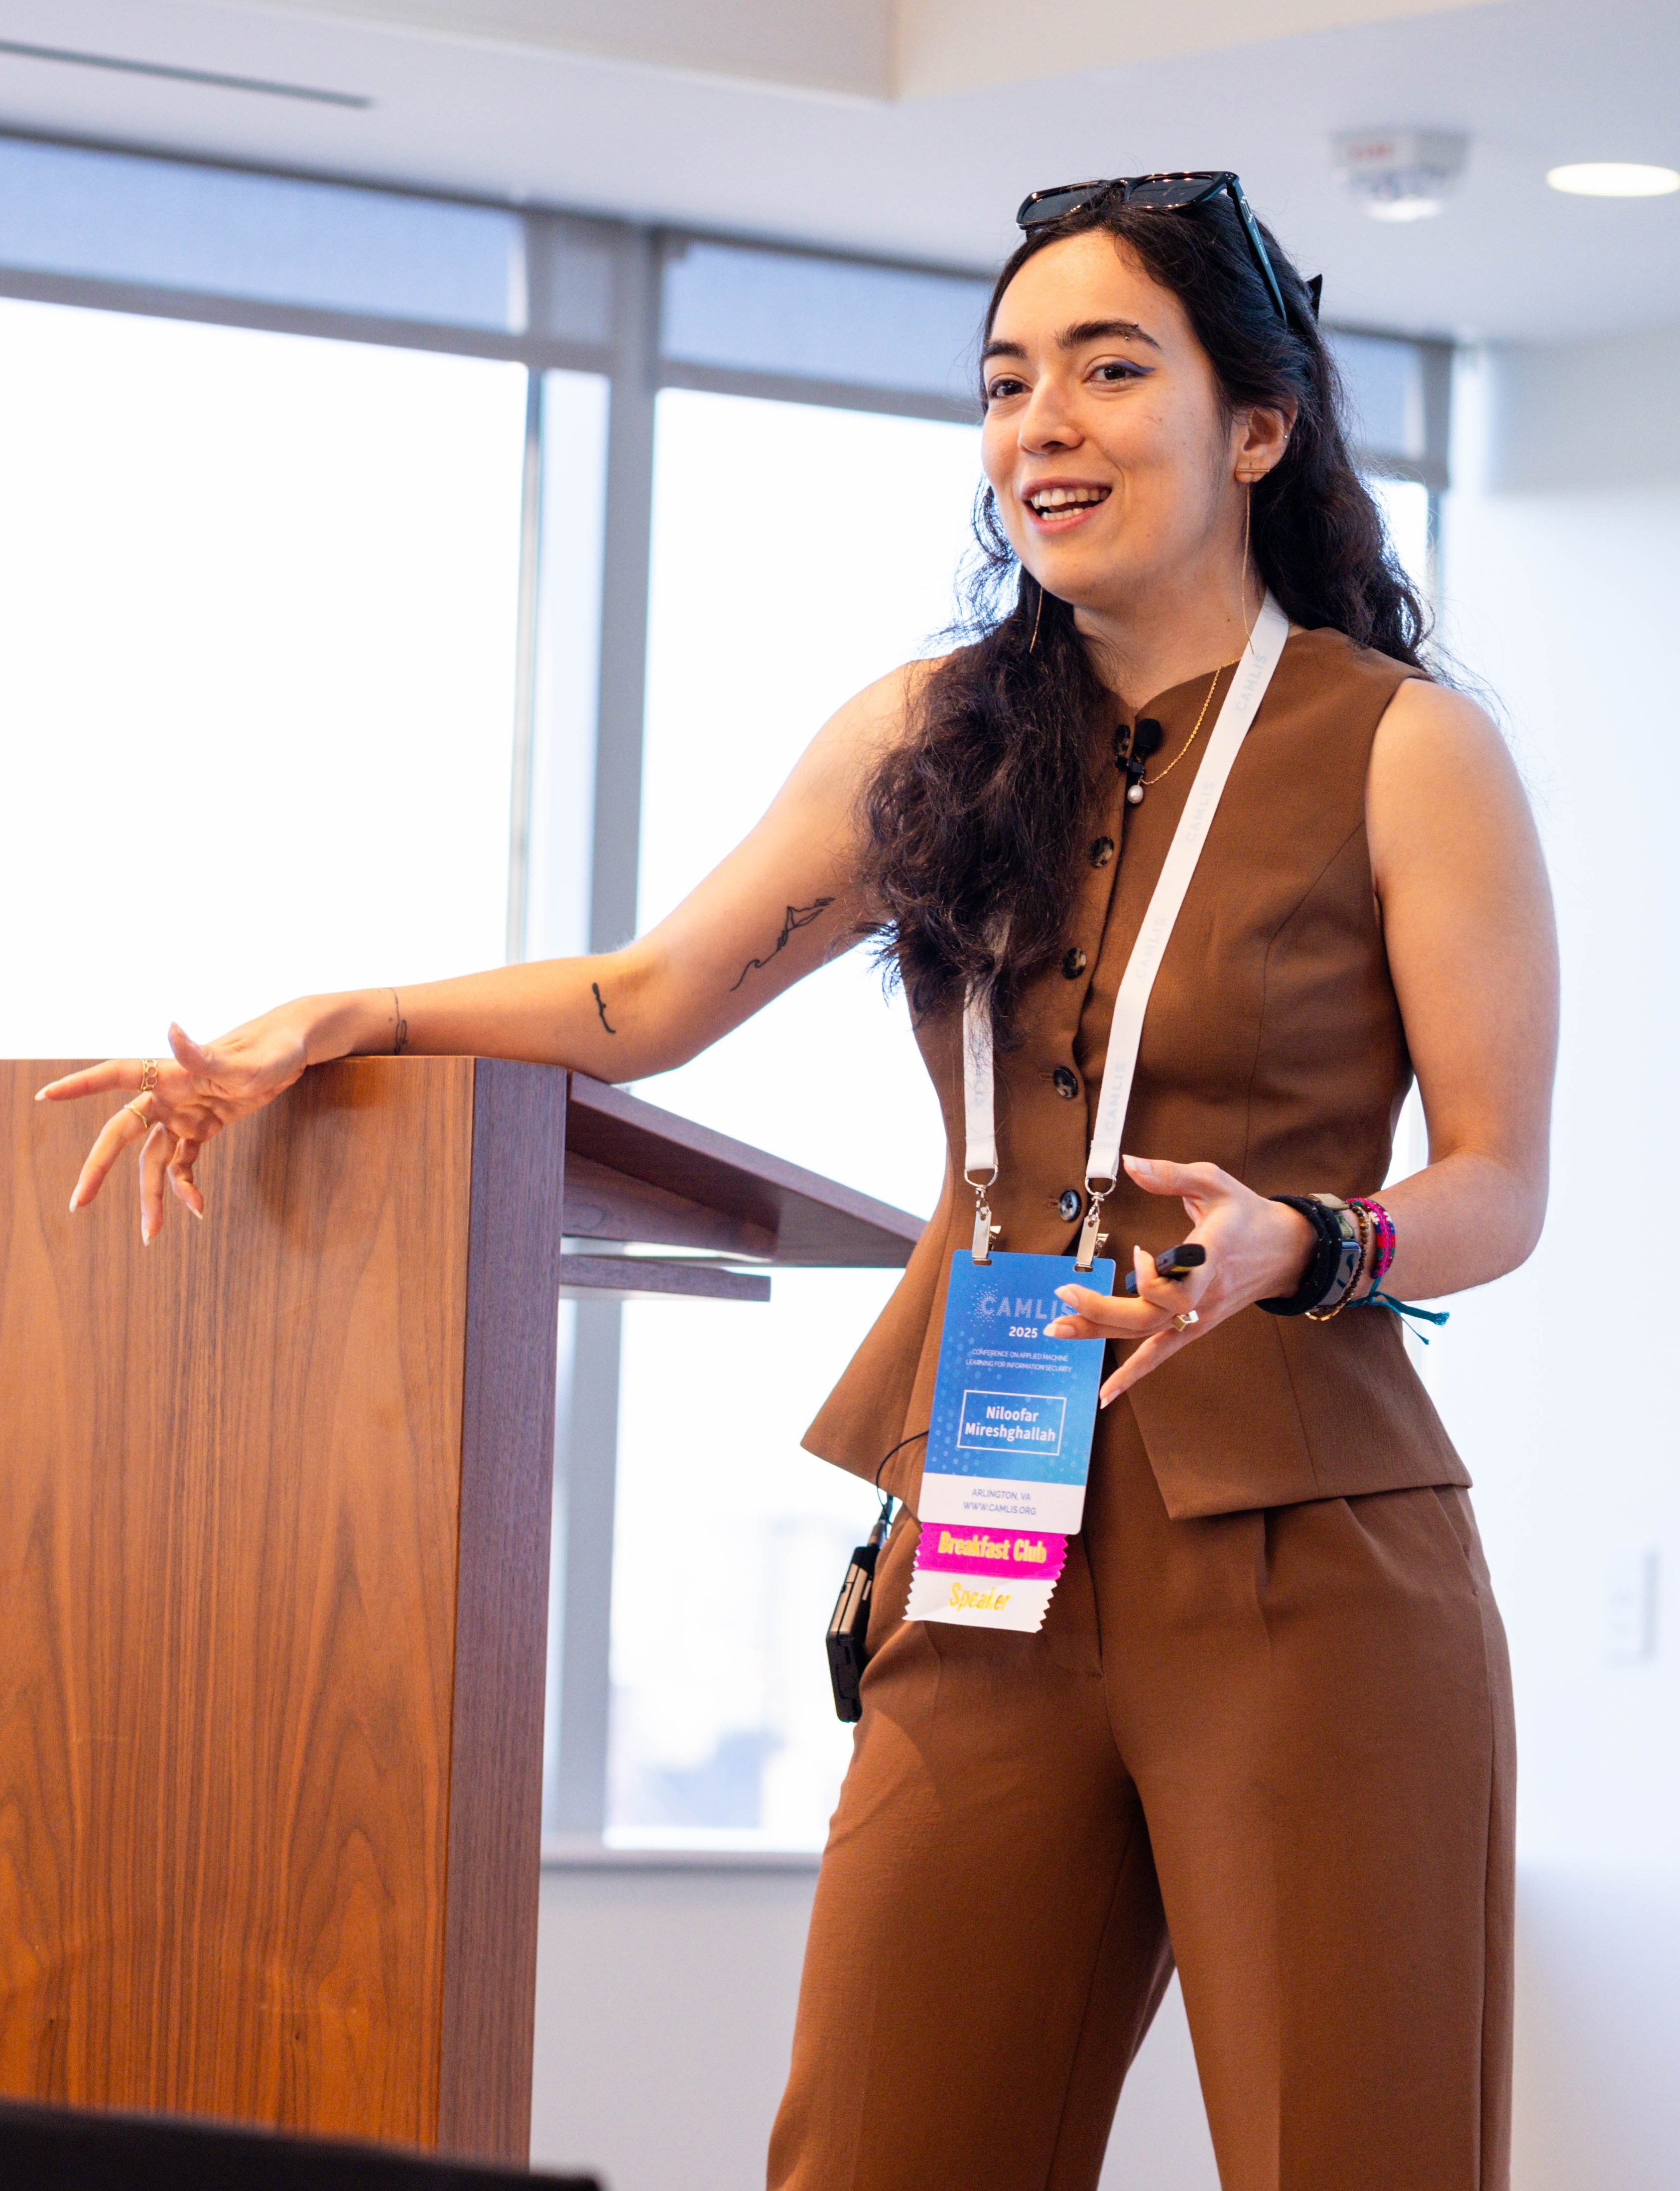
Niloofar Mireshghallah
Thema:Humans&, CMU
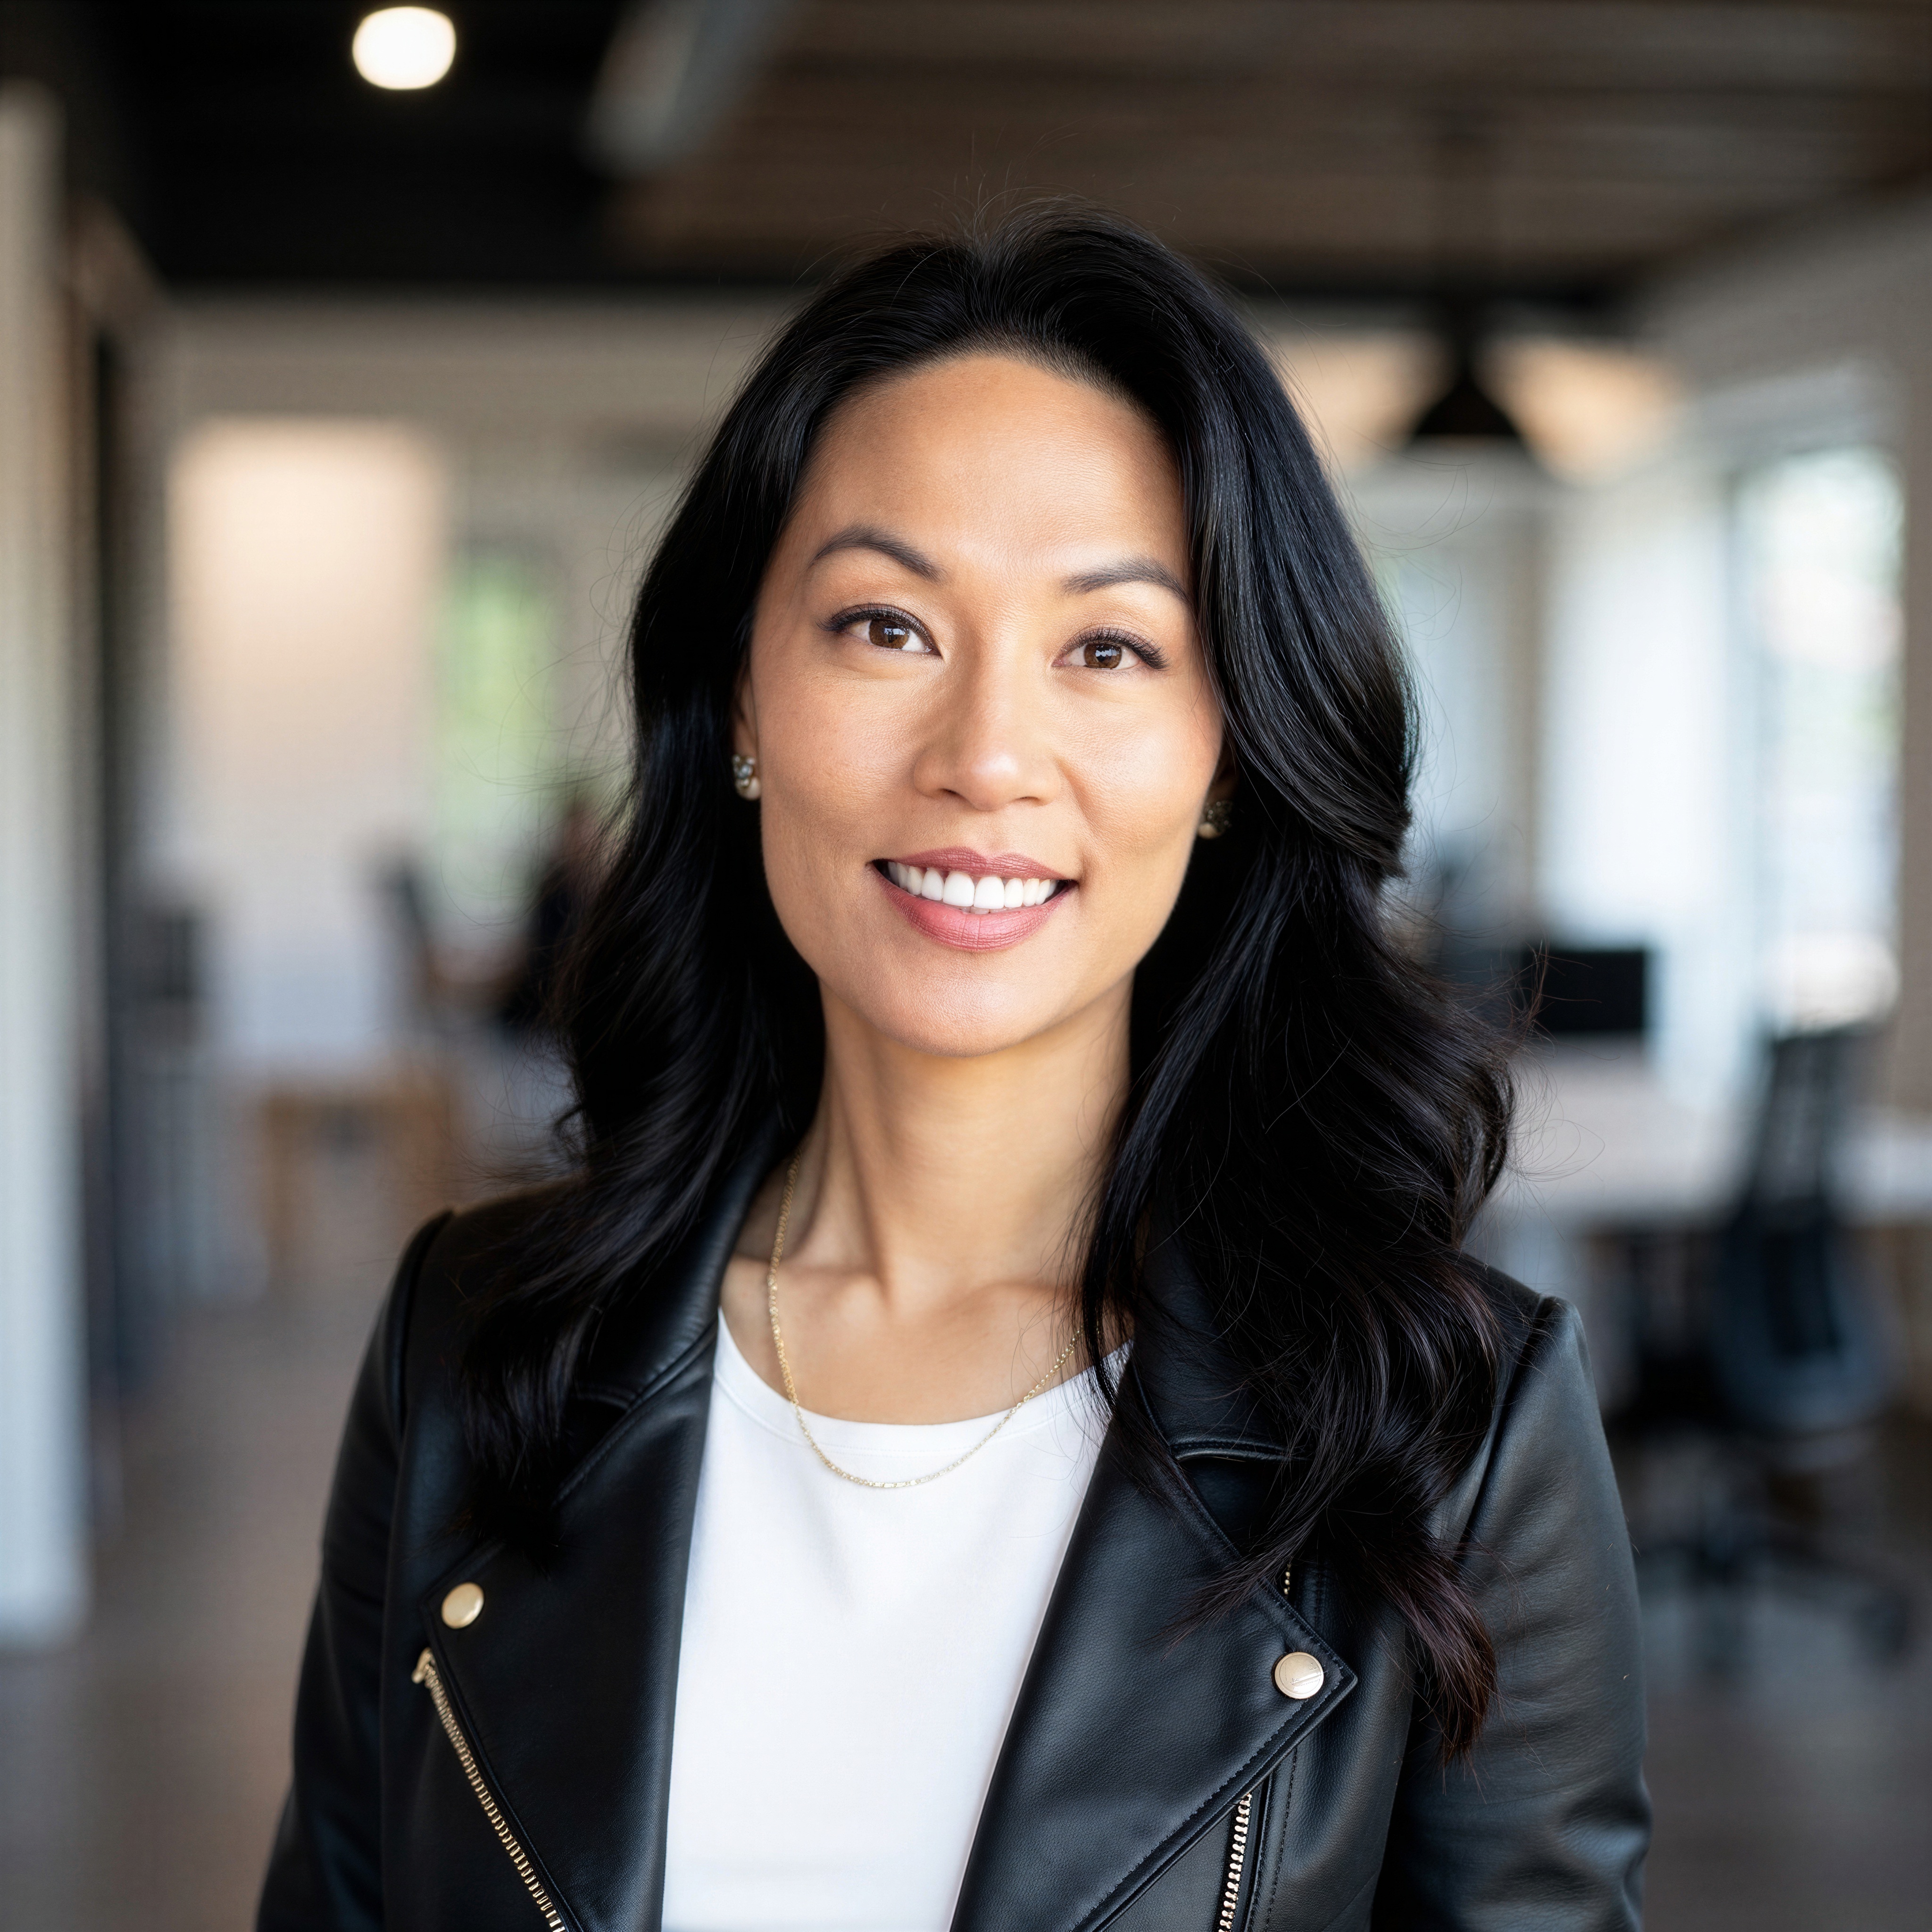
Janel Thamkul
Thema:Deputy General Counsel, ex-Anthropic, ex-Google
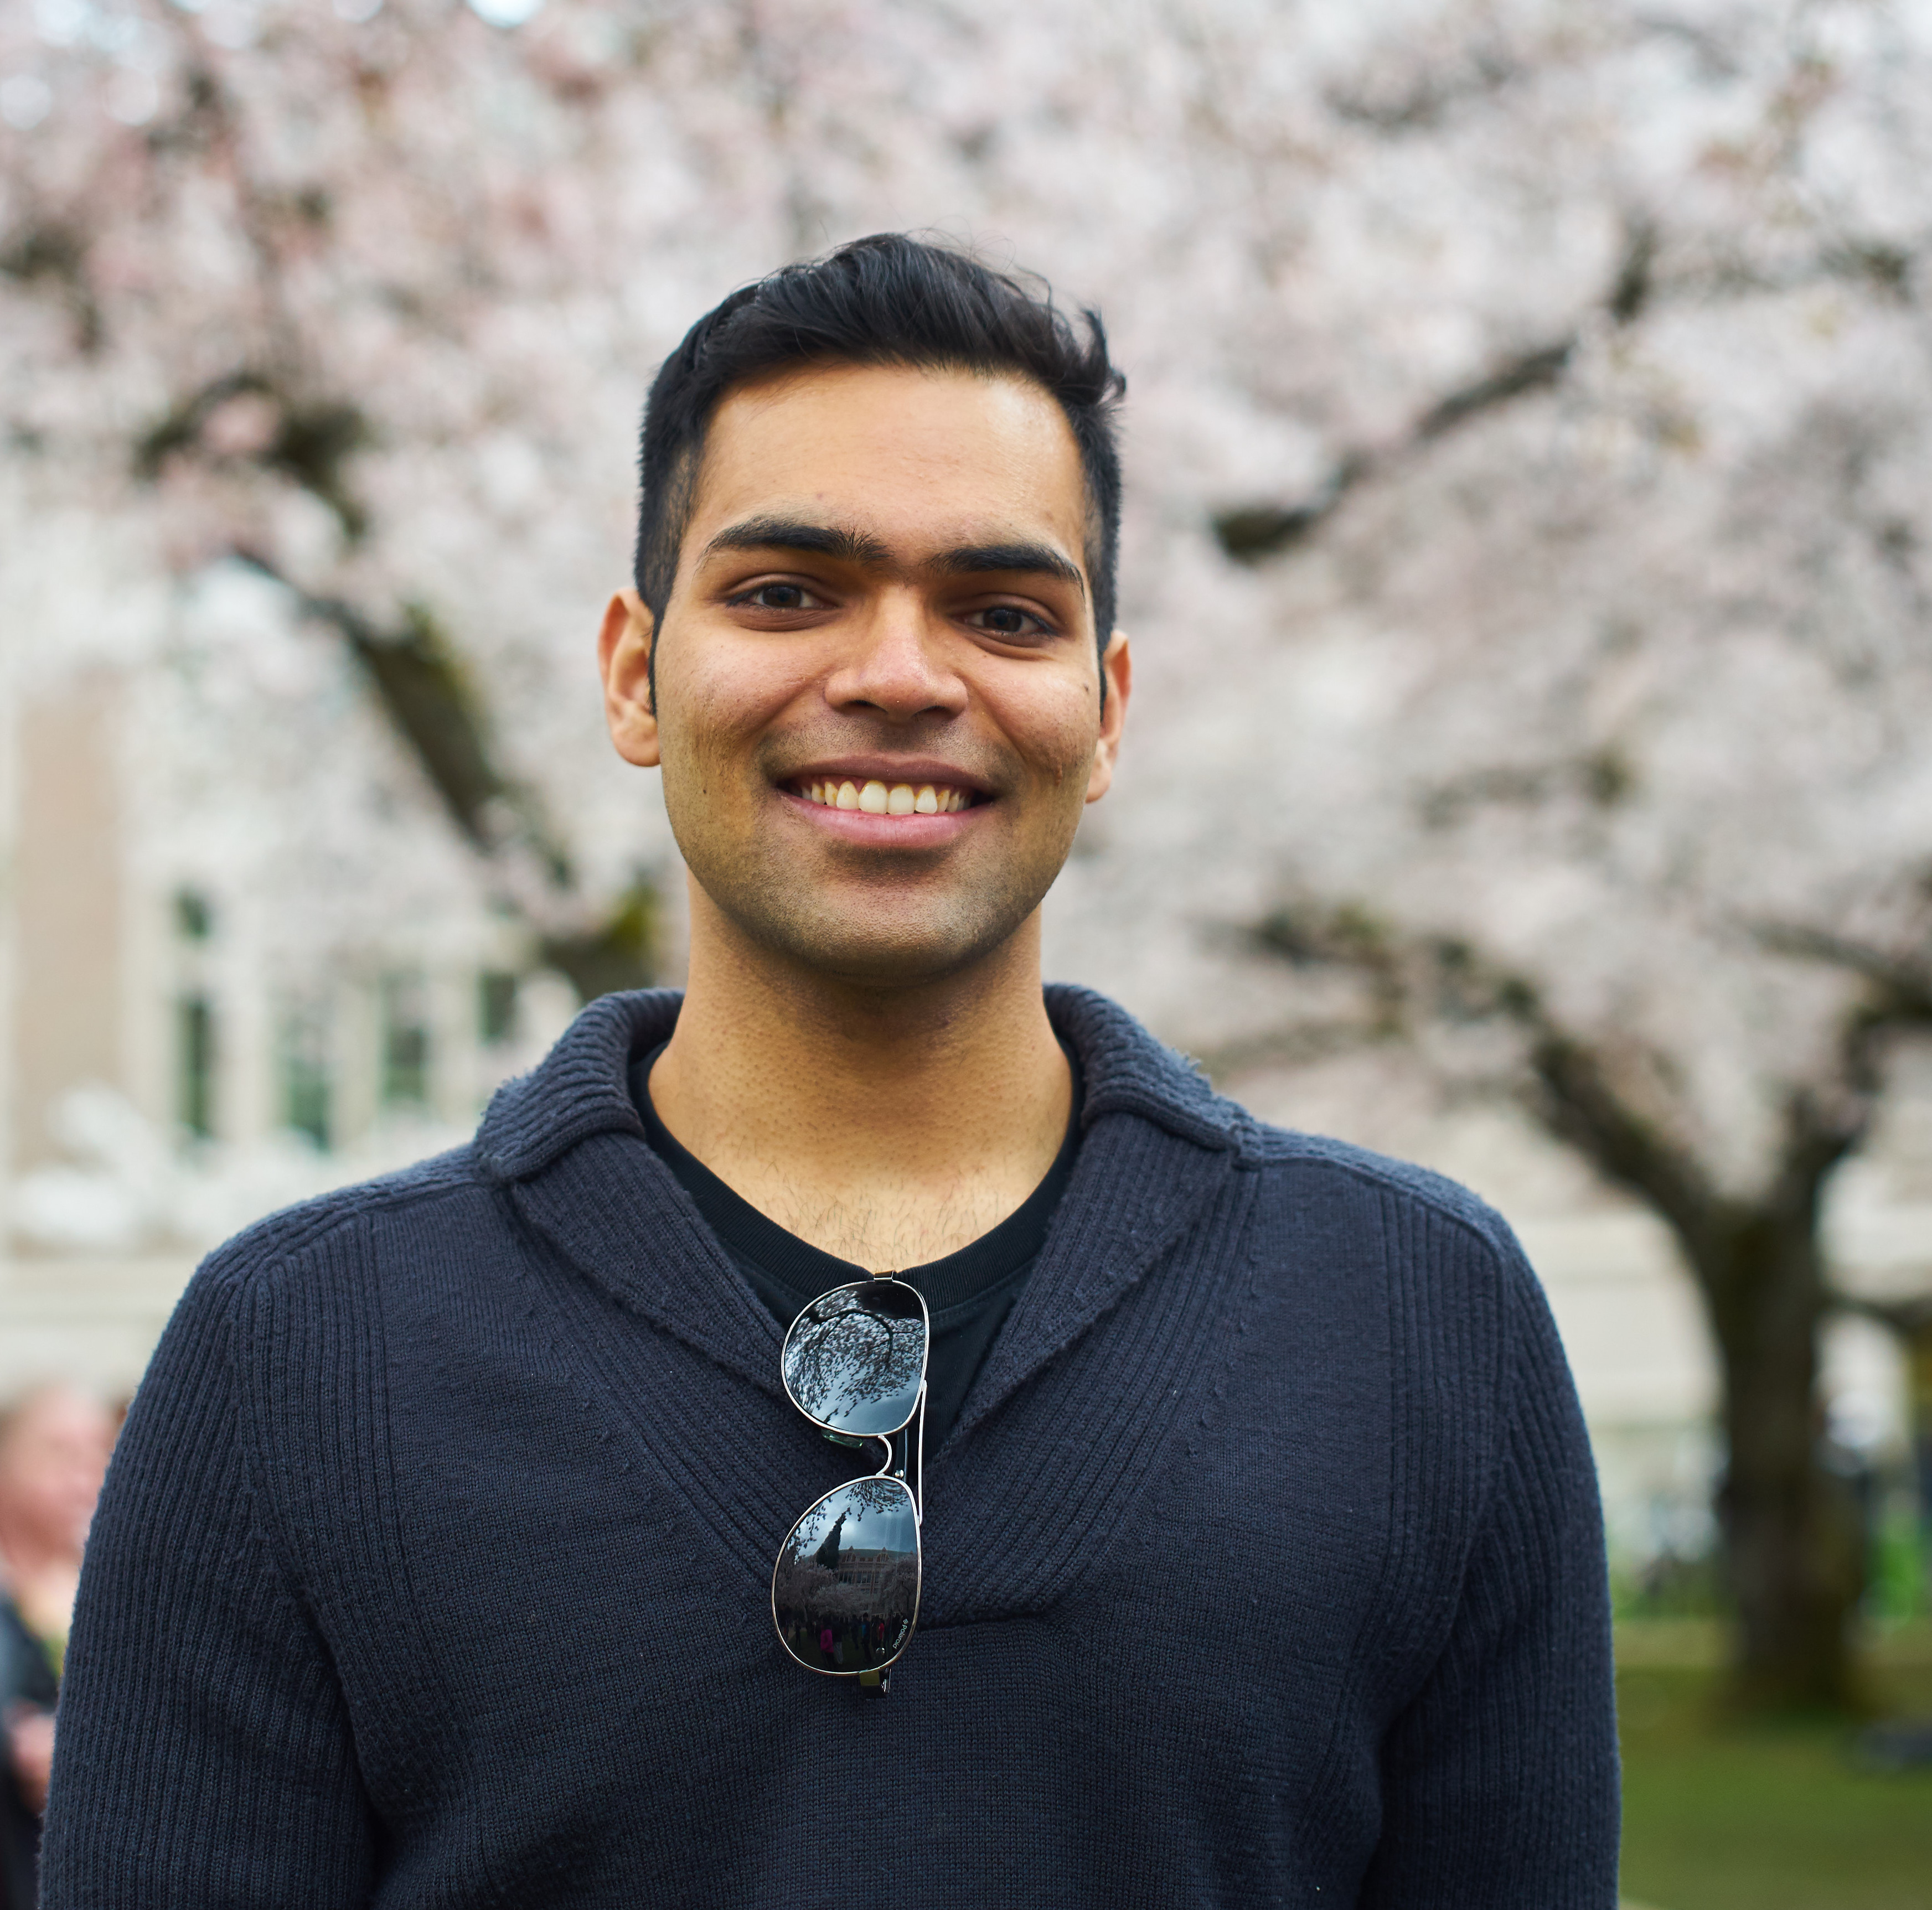
Krishna Pillutla
Thema:IIT Madras
Verwandte Events

Google Cloud Security Summit - AMER
Agentic Data Cloud Live
Agentic AI Summit '26 Herbst
KI-Agenten für die Produktion erstellen und bereitstellen
Gemini Akademie
Live-Demonstration: der KI-Agent, der enki's CFO-Hackathon gewonnen hat
[Online] Daten- & KI-Produktmanagement-Netzwerkstunde
[Online] Daten- & KI-Produktmanagement Netzwerkstunde
[Online] Daten- und KI-Produktmanagement Networking-Stunde
[Online] Daten- & KI-Produktmanagement Networking-Stunde
[Online] Daten- & KI-Produktmanagement Networking-Stunde