24. September - Meetup zu KI, ML und Computer Vision
Beschreibung
Nehmen Sie an unserem virtuellen Meetup am 24. September teil, um Vorträge von Experten zu aktuellen Themen in den Bereichen KI, ML und Computer Vision zu hören. Datum, Uhrzeit und Ort 24. September 2026, 9:00 - 11:00 Uhr PST Online. Registrieren Sie sich für Zoom! Wie gestalten die KI-Prinzipien von Mercedes-Benz unsere Innovation? Bei Mercedes-Benz leiten unsere KI-Prinzipien jeden Schritt der Innovation und betonen den verantwortungsvollen Einsatz, Sicherheit und Zuverlässigkeit, Erklärbarkeit und den Schutz der Privatsphäre. Diese Prinzipien gehen über bloße Aussagen hinaus und prägen aktiv, wie wir KI-Systeme in realen Automobil- und Unternehmensanwendungen entwerfen, testen und implementieren. In diesem Vortrag werde ich präsentieren, wie diese Prinzipien unsere aktuelle Forschung dazu inspiriert haben, wann die Wiederverwendung von LoRA (Low-Rank Adaptation) effektiv ist. Durch die Kombination von theoretischen Analysen mit synthetischen Daten als Proxy für Unternehmensszenarien haben wir die Stärken und Schwächen modularer KI-Komponenten unter eingeschränktem Datenzugang entdeckt. Unsere Ergebnisse bieten praktische Hinweise darauf, wann wiederverwendete LoRAs hochwertige Ergebnisse liefern können. Über den Sprecher Mei-Yen Chen ist Senior Data Scientist bei Mercedes-Benz Tech Innovation GmbH in Deutschland und verfügt über 10 Jahre Branchenerfahrung in KI und Datenlösungen. Sie leitet Projekte im frühen Stadium im Bereich KI über verschiedene Geschäftsbereiche hinweg und arbeitet mit Forschungseinrichtungen zu maschinellem Lernen und verantwortungsvoller KI zusammen. Region Tokens als visuelles Element: Von der Erkennung zur Weltmodellierung Die patchbasierte Tokenisierung ist zum Standardinterface zwischen Vision-Encodern und nachgelagerten Modellen geworden, doch Patches tragen keine semantische Struktur und skalieren schlecht mit Auflösung und zeitlichem Umfang. Dieser Vortrag stellt ein Forschungsprogramm vor, das darauf abzielt, Patch-Tokens durch regionsbasierte Repräsentationen zu ersetzen — semantisch dichte Tokens, die in visuellen Entitäten und nicht in willkürlichen Rasterausschnitten verwurzelt sind. Ich werde RELOCATE, REN und T-REN beschreiben, eine Abfolge von Methoden, die Regionstokens durch Pooling erzeugen, sie mit zielgerichteten regionalen Zielen trainieren und auf Video mit zeitlicher Kohärenz erweitern. Anschließend werde ich laufende Arbeiten vorstellen, die Regionstokens in VLMs integrieren, um direkt die Kapazität des visuellen Kontexts zu erweitern, und erste Ergebnisse zur Vorhersage zukünftiger Regionstrajektorien als Grundlage für die Weltmodellierung präsentieren. Die grundlegende These ist, dass regionale Tokens eine natürlichere Einheit der visuellen Berechnung als Patches darstellen und ihr Vorteil sich verstärkt, wenn die Aufgabenkomplexität, Auflösung und der zeitliche Horizont zunehmen. Über den Sprecher Savya Khosla ist Doktorand im zweiten Jahr an der University of Illinois Urbana-Champaign, betreut von Prof. Derek Hoiem und Prof. Alex Schwing. Nutzung von Text-zu-Bild-Diffusionsmodellen für konsistente Set-zu-Set-Generierung Bildkollektionen sind die primäre Art und Weise, wie Menschen die Welt festhalten, doch Fortschritte im Bereich der generativen Bearbeitung sind in diesem Bereich weitgehend nicht anwendbar. Wir adressieren diese Lücke, indem wir Match-and-Fuse einführen - eine Zero-Shot, trainingsfreie Methode zur konsistenten Set-zu-Set-Generierung aus Bildkollektionen, die ein gemeinsames visuelles Element teilen, jedoch in Sichtwinkel, Erfassungszeit und umgebenden Inhalten variieren. Unsere zentrale Idee ist ein einheitlicher graphbasierter Rahmen, der dichte Entsprechungen mit einem emergierenden Vorwissen in Text-zu-Bild-Diffusionsmodellen kombiniert, um kohärente Leinwände zu erstellen. Wir erzielen eine herausragende Konsistenz und visuelle Qualität und eröffnen neue kreative Möglichkeiten für die Inhaltserstellung. Über den Sprecher Kate Feingold ist Doktorandin im Bereich Computer Vision am Weizmann Institute of Science. Ihre Forschung befindet sich an der Schnittstelle von generativen Modellen, 3D/4D-Wahrnehmung und multimodalem Lernen und konzentriert sich auf Probleme, bei denen Vision auf andere Modalitäten oder Paradigmen in kreativen Aufgaben trifft. Ertragsschätzung eines Kaffees in einer dichten Umgebung Diese Präsentation bietet einen detaillierten Arbeitsablauf zur Ertragsschätzung von Kaffee in einer dichten Umgebung. Mit Fotos von Kaffeepflanzen vor der Ernte aus verschiedenen Kaffeegütern, einschließlich Details zur Vorverarbeitung, Annotation zur Erkennung von Interessengebieten (ROI), Objekt-Detektions-Training und -Ergebnissen mit verschiedenen Yolo-Modellen und schließlich Segmentierung mit SAM2 und Yolo*-Seg und den Trainings- und Ergebniswerten zur Bestimmung der Anzahl von rohen, unreifen, reifen und überreifen Kaffeekirschen und schließlich dem Ertrag des gesamten Anwesens. All dies basiert auf realen Daten, die mit iPhones und Android-Telefonen erfasst wurden. Über den Sprecher Raghu M. Rao ist Berater, der an Anwendungen von Computer Vision KI-Modellen arbeitet. Zuvor war er bei AMD und Xilinx tätig. Er besitzt einen Doktortitel in Wireless Communications von der UCLA und ist Senior Member, IEEE. Seine aktuellen Interessen liegen in der Anwendung von KI in der Landwirtschaft, Gesundheitswesen und drahtlosen Kommunikation.
Lassen Sie Ihr Netzwerk wissen, dass Sie dabei sind
Teilen Sie diese Veranstaltung, um Gespräche zu beginnen, Kollegen einzuladen und sich vorab zu vernetzen.
Verwandte Events
Baue, was du dir vorstellst: KI-gestütztes App-Bauen mit Base44
No-Code Workshop: Erstellen Sie Ihre erste Website mit KI 👾
Künstliche Intelligenz im Klassenzimmer
Wöchentlicher Runder Tisch: Ihr Inhalt klingt, als hätte er von KI geschrieben worden.
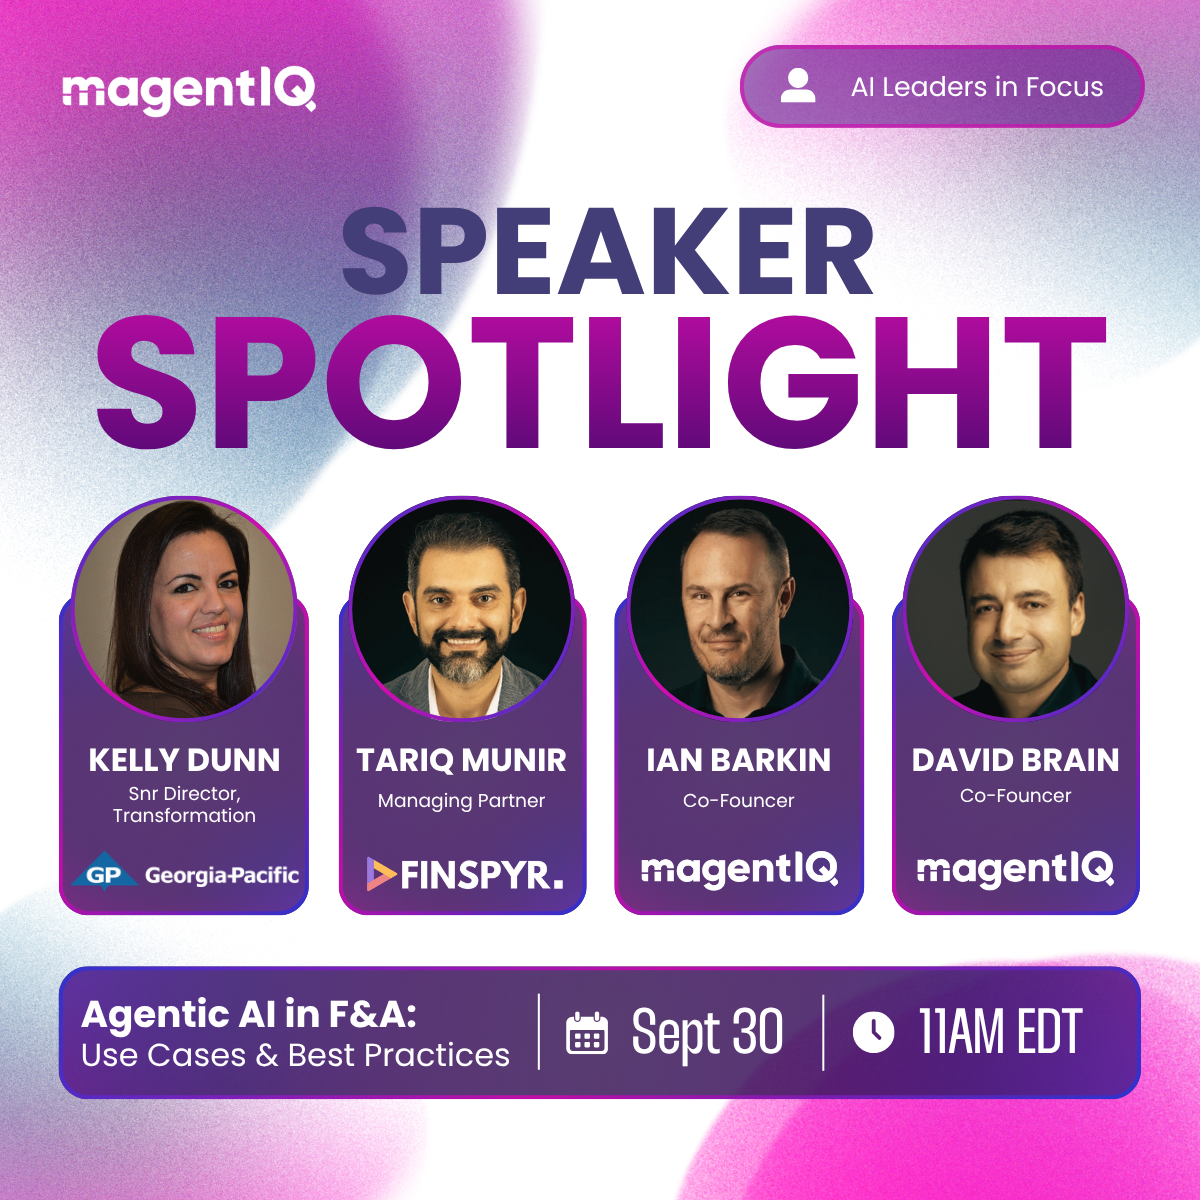
Agentic AI in Finanz- und Rechnungswesen: Anwendungsfälle und Best Practices
Bittensor Indien: Gemeinschaftsversammlung im September 🇮🇳
Vibe Coding für Unternehmen: Wie man Apps sicher und geregelt vibecodiert