
Lernschicht Papier Leseclub - Woche 33 - SlopCodeBench
Beschreibung
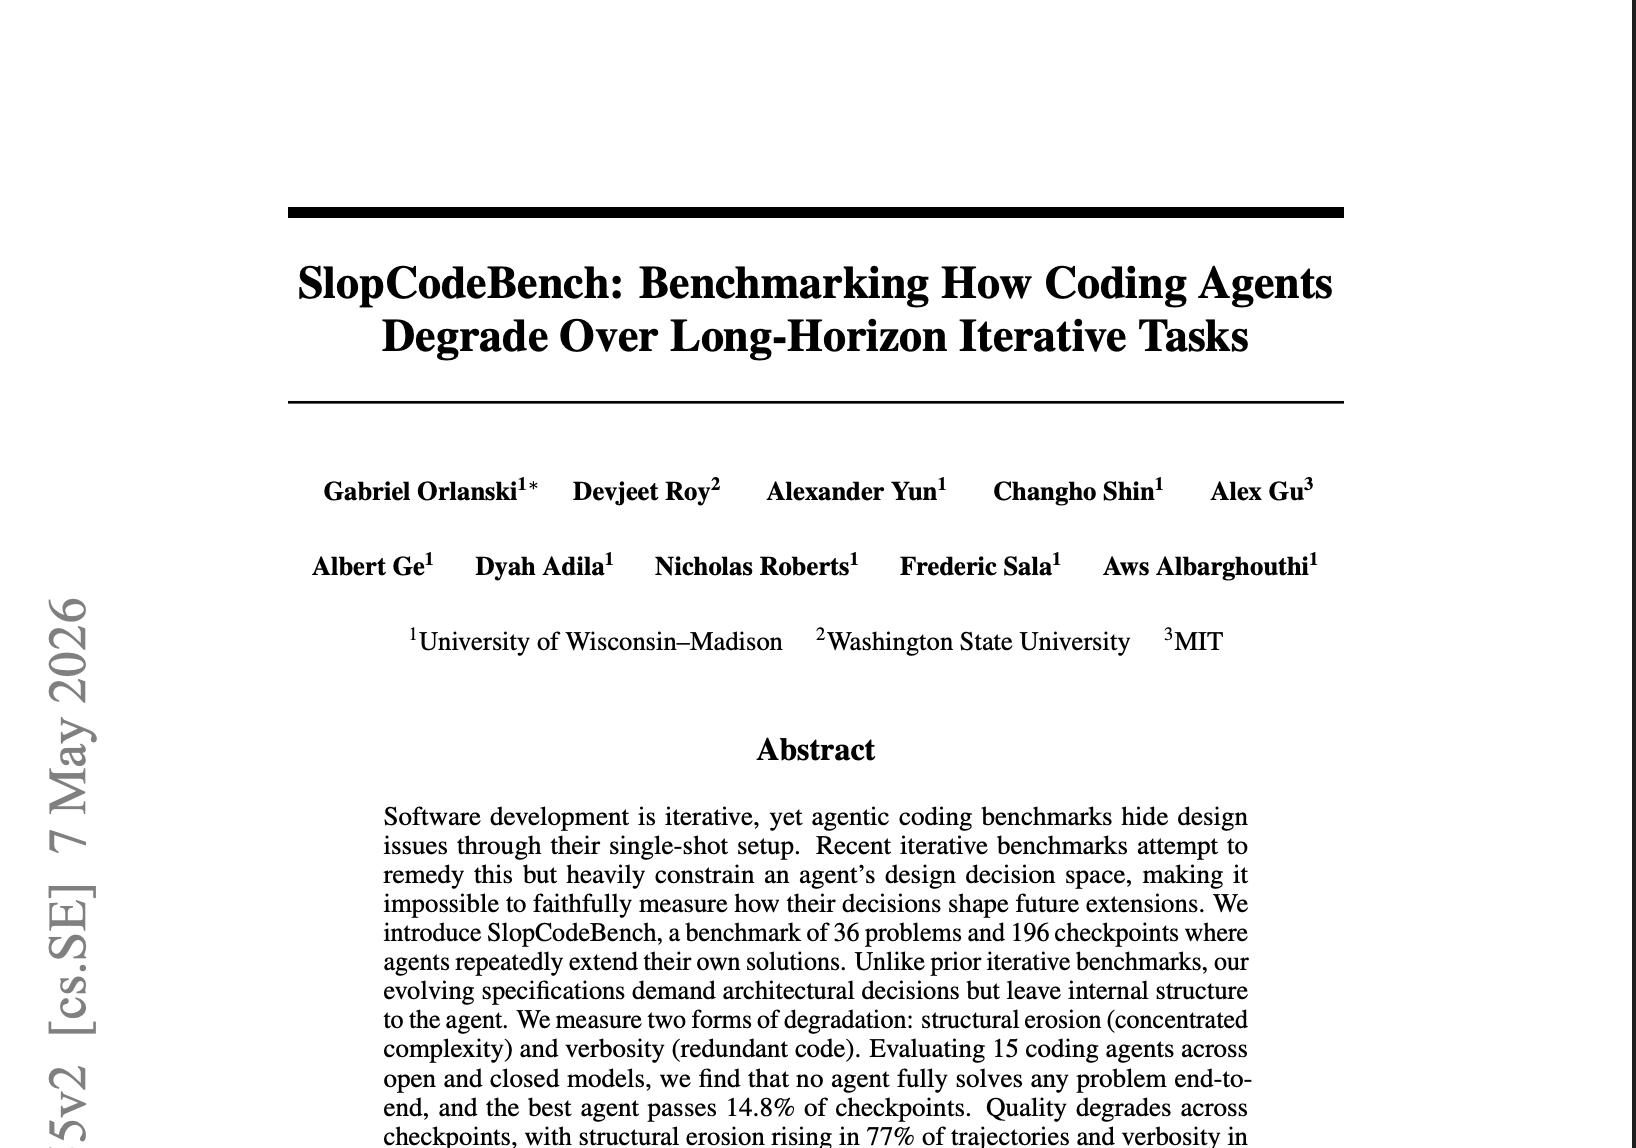
Diese Woche Papier:SlopCodeBench: Benchmarking, wie sich Coding-Agenten über lange iterative Aufgaben verschlechtern Link: https://arxiv.org/abs/2603.24755Website: https://www.scbench.ai/Code: https://github.com/SprocketLab/slop-code-bench Zusammenfassung: Fast jeder Coding-Benchmark fordert einen Agenten auf, ein Problem einmal von Grund auf zu lösen. Echte Software wird nicht so erstellt — sie wird immer wieder von jemandem erweitert, der an einem bereits bestehenden Code arbeitet. Ein einzelner Test verdeckt das, worüber Praktiker sich tatsächlich Sorgen machen: nicht ob ein Agent einen Test heute bestehen kann, sondern wie sein Code nach zwanzig Runden "handhabe jetzt auch dies" aussieht. SlopCodeBench misst das. Es ist ein Benchmark von 36 Problemen und 196 Prüfungen, bei dem ein Agent wiederholt seine eigene vorherige Lösung erweitert, wenn neue Anforderungen eintreffen. Die Spezifikationen beschreiben absichtlich nur das äußere Verhalten - einen CLI- oder API-Vertrag - und sagen nichts über Architektur, Funktionssignaturen oder Modulgrenzen, sodass frühe Designentscheidungen die eigene des Agenten sind und sich über den Verlauf summieren. Die Test Suite bleibt verborgen, damit sie keine strukturellen Hinweise preisgibt. Zusammen mit der Richtigkeit verfolgen die Autoren zwei Formen der Verschlechterung: strukturelle Erosion (Komplexität konzentriert sich in bereits komplexen Funktionen) und Wortfülle (Wachstum redundanter, duplizierter Codes). Die Ergebnisse sind düster. Bei 15 offenen und geschlossenen Coding-Agenten löst keiner ein einzelnes Problem von Anfang bis Ende vollständig, und der beste besteht 14,8 % der Prüfungen. Die Qualität sinkt, während die Trajektorien länger werden: strukturelle Erosion steigt in 77 % der Läufe und Wortfülle in 75,5 %. Der Vergleich, der dem Papier seinen Namen gibt: im Vergleich zu 473 Open-Source-Python-Repositories ist der Agenten-Code 2,3-mal wortreicher und 2,0-mal erodierter, und die menschlichen Repos verschlechtern sich seltener und in kleineren Margen über ihre Git-Historien. Das ausdrückliche Anweisen des Agenten, sauberen Code zu schreiben, reduziert die anfängliche Wortfülle und Erosion um bis zu ein Drittel - hat aber keine Auswirkung auf die Verschlechterungsrate. Relevant für alle, die Code mit einem Agenten im Loop ausliefern, und für alle, die darüber nachdenken, wie man agentisches Verhalten über lange Zeiträume bewerten kann. Keine Vorbereitung erforderlich - kommen Sie, lesen und diskutieren Sie mit uns. Jason Carver wird diese Woche das Papier vorstellen Was ist der Lernschicht Labs Papier Leseclub? Eine Initiative von https://www.learninglayer.ai, einem Labor mit dem Ziel, die KI-Angst in der Welt zu reduzieren. Wie ist das Format? Diskussionsbasiert. Erwarten Sie eine stressfreie Umgebung, um Einsichten und Meinungen mit der Gruppe zu teilen. Was sind die Ziele der Gruppe? Immer auf dem neuesten Stand der KI-Forschung zu bleiben und das Verständnis der KI-Grundlagen + Mathematik zu verbessern. Wer ist willkommen? Jeder! Versuchen Sie, mindestens etwas Zeit mit dem Papier zu verbringen, und kommen Sie mit Fragen oder Dingen, die Sie besprechen möchten, vorbereitet, aber es ist auch in Ordnung einfach zu erscheinen! Lernschicht Labs Team:
Veranstaltungsort
Lassen Sie Ihr Netzwerk wissen, dass Sie dabei sind
Teilen Sie diese Veranstaltung, um Gespräche zu beginnen, Kollegen einzuladen und sich vorab zu vernetzen.
Verwandte Events

Hören Sie auf, KI-Agenten zu bauen – beginnen Sie, KI-FÄHIGKEITEN zu entwickeln. Ein vollständiges Tutorial Mi, 1. Juli · 17:30 Uhr EDT von Tampa Bay Biotech.
UX-Ai-Zusammenarbeit: Treffen
Community Round Table: KI, Agenten, Fähigkeiten und MCP | DenverScript Juni 2026
AI Meetup (Juli): GenAI LLMs und Agenten
Streaming/ Tribe #26 - Können Startups dank KI autonom werden?
Aufbau eines KI-fähigen Unternehmens Dienstag, 23. Juni, 17:30 Uhr EDT von Entrepreneurs Learning & Growth Hub Icon 4.
Sommer-AI-Studiengruppensaisonauftakt
AI-Engineering-Grundlagen
7 Plätze verfügbarAI Happy HourDi, 23. Juni · 19:00 Uhr EDTvon AI Club3 Teilnehmer
Die KI-Untergrund - Konferenz
KI-Denkfabrik. Lernen, mit KI Geld zu verdienen.