
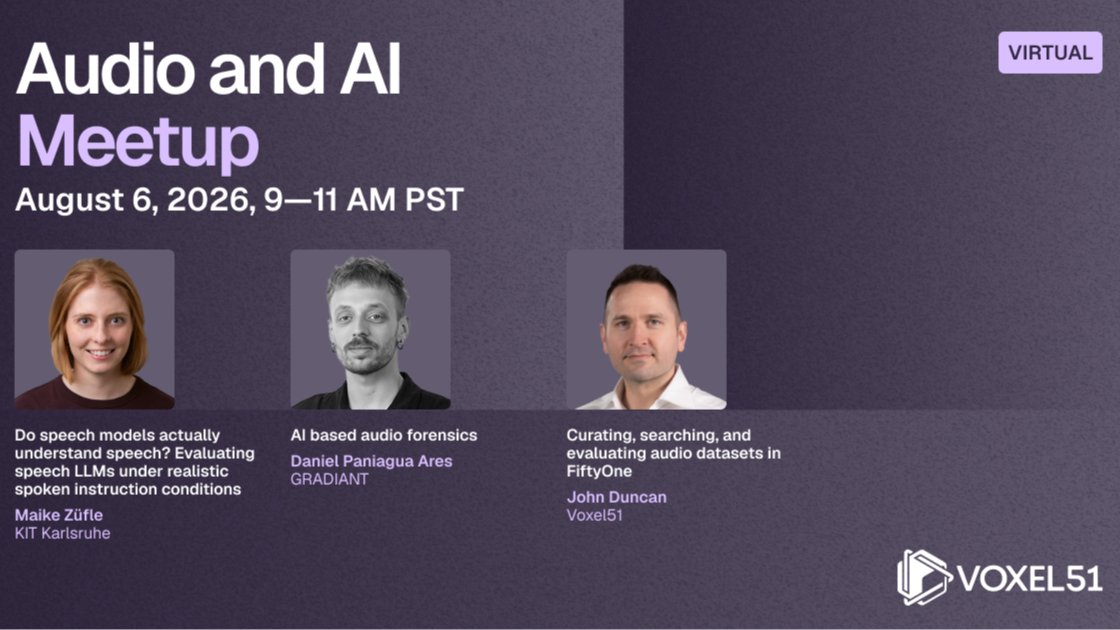
6. Aug - Audio und KI Meetup
Beschreibung
Nehmen Sie an unserem virtuellen Meetup teil, um Vorträge von Experten über bahnbrechende Themen in den Bereichen KI, ML und Computer Vision zu hören. Datum, Uhrzeit und Ort 06. August 2026, 9:00 - 11:00 Uhr PST Online. Melden Sie sich für Zoom an! Verstehen Sprachmodelle tatsächlich Sprache? Bewertung von Sprach-LLMs unter realistischen Bedingungen für gesprochene Anweisungen Sprach-Modelle großer Sprache (SLLMs) sind zunehmend leistungsfähig; aber bewerten wir sie auf die richtige Weise? Die meisten Benchmarks basieren auf Textaufforderungen, jedoch interagieren echte Benutzer mit diesen Systemen über Sprache, eine Modalität, die Rauschen, Unflüssigkeiten und stilistische Variationen einführt, die Text einfach nicht erfasst. In diesem Vortrag präsentieren wir Ergebnisse einer systematischen Studie über 11 Aufgaben, 12 Sprachen und fünf Eingabestile, in der untersucht wird, wie sich Eingabemodalität, Sprache und Aufgabentyp auf die Leistung von SLLMs auswirken. Über den Sprecher Maike Züfle ist Doktorandin am Karlsruher Institut für Technologie (KIT) und arbeitet in der Gruppe von Prof. Jan Niehues an interaktiven Sprachsystemen für eine natürlichere Kommunikation zwischen Mensch und Maschine. Ihre Forschung konzentriert sich auf anweisungsfolgende Sprachmodelle mit Sprache als Eingabe und Ausgabe, mit einem jüngsten Fokus auf Voll-Duplex-Systeme. Neben ihrer Forschung organisiert sie die gemeinsamen Aufgaben zur Bewertung von anweisungsfolgender und Sprachübersetzung bei IWSLT. Sie ist eine 2026 Apple Scholar in KI/ML. KI-basierte Audioforensik In dieser Präsentation werden die Teilnehmer mehrere Module entdecken, die von Gradiant zur Erkennung und Analyse von synthetisch erzeugtem oder manipuliertem Audio entwickelt wurden. Die Sitzung wird von einem der Entwickler durchgeführt, die an der Gestaltung und Implementierung dieser Technologien beteiligt sind und Einblicke in deren Fähigkeiten und zugrunde liegende Methodik bieten. Die Präsentation wird das Rückverfolgbarkeitsmodul abdecken, das hilft, den Ursprung von KI-generierten Inhalten zu identifizieren. Außerdem wird das Segmenterkennungswerkzeug behandelt, das dazu dient, manipulierte Bereiche innerhalb einer Audioaufnahme zu lokalisieren, sowie das vollständige Audioerkennungstool, das bewertet, ob eine gesamte Aufnahme synthetisch erzeugt wurde. Über den Sprecher Daniel Paniagua Ares ist Forschungsingenieur bei Gradiant. Er hat Informatik an der FIC studiert und einen Master-Abschluss in KI von der VIU. Kurierung, Suche und Bewertung von Audiodatensätzen in FiftyOne In diesem Vortrag beginnen wir mit dem ESC-50-Datensatz für Umgebungsgeräusche, um zu zeigen, wie FiftyOne Audio darstellt: Durchsuchen von Clips in der tabellarischen Ansicht, Rendering von Spektrogrammen direkt im Musterfeld mit einem benutzerdefinierten Renderer und Umwandlung von Klängen in durchsuchbare Vektoren mit CLAP-Embeddings. Danach demonstrieren wir ein Ähnlichkeitssuchfeld, mit dem Sie eine gesamte Audiosammlung anhand eines Beispielfragments oder einer natürlichen Spracheingabe abfragen können, um schnell übereinstimmende Klänge zu finden. Wir schließen mit einem Live-Forschungsproblem ab: Abruf von Audio-Momenten aus der DCASE 2026 Challenge, bei der das Ziel darin besteht, den genauen Moment in einer langen Aufnahme zu lokalisieren, der einer Texteingabe entspricht. Wir rahmen dies als zeitliche Erkennung, bewerten Vorhersagen und visualisieren den tatsächlichen vs. vorhergesagten Moment auf einer interaktiven Zeitleiste, um die Fehlerarten des Modells intuitiv aufzuzeigen. Die Teilnehmer werden mit einem konkreten Plan und offenem Code für die Anwendung visueller datenzentrierter KI-Praktiken auf ihre eigenen Audio- und multimodalen Datensätze gehen. Über den Sprecher John Duncan ist Maschinenlern-Ingenieur, Customer Success bei Voxel51. Zu seinen Forschungsinteressen gehören Vision, LiDAR und Audio-Wahrnehmung für Roboter und intelligente Systeme.
Veranstaltungsort
Lassen Sie Ihr Netzwerk wissen, dass Sie dabei sind
Teilen Sie diese Veranstaltung, um Gespräche zu beginnen, Kollegen einzuladen und sich vorab zu vernetzen.
Verwandte Events

Hören Sie auf, KI-Agenten zu bauen – beginnen Sie, KI-FÄHIGKEITEN zu entwickeln. Ein vollständiges Tutorial Mi, 1. Juli · 17:30 Uhr EDT von Tampa Bay Biotech.
UX-Ai-Zusammenarbeit: Treffen
Community Round Table: KI, Agenten, Fähigkeiten und MCP | DenverScript Juni 2026
AI Meetup (Juli): GenAI LLMs und Agenten
Streaming/ Tribe #26 - Können Startups dank KI autonom werden?
Aufbau eines KI-fähigen Unternehmens Dienstag, 23. Juni, 17:30 Uhr EDT von Entrepreneurs Learning & Growth Hub Icon 4.
Sommer-AI-Studiengruppensaisonauftakt
AI-Engineering-Grundlagen
7 Plätze verfügbarAI Happy HourDi, 23. Juni · 19:00 Uhr EDTvon AI Club3 Teilnehmer
Die KI-Untergrund - Konferenz
KI-Denkfabrik. Lernen, mit KI Geld zu verdienen.