Безпека моделей штучного інтелекту
Опис
Безпека моделей🚨 Сесія 5: Видання Leak & BuildЧастина 1 - LLM02: Розкриття чутливої інформаціїТі речі, які витікають з AI додатків: ключі API, клієнтські записи, системні підказки, розмови інших людей. Ця категорія займала #6 в оригінальному OWASP Top 10 для LLM. У оновленні 2026 року вона стрибнула на #2, прямо за ін'єкцією підказок, і займає це місце у 2026 році. Ми розглянемо, як ці витоки насправді відбуваються. Більшість з них не потребують злому, лише нормального використання, і що насправді їх зупиняє.Частина 2: Дизайнерська вправа: створити безпечну агентну системуЩось нове в цій сесії. Замість того, щоб говорити лише про зламані системи, ми проектуємо таку, яка не є. Разом ми будемо складати модель загроз для агентного AI додатка, де він може витікати, де його можна перехопити - а потім намалюємо безпечну архітектуру для нього. Ви займаєтеся практичним дизайном, а не лише слуханням.Спочатку розмова, потім вправа, потім відкрите обговорення. Жодних презентацій від постачальників. Початківці вітаються!📩 RSVP (або щоб представити на майбутній сесії): [email protected]📅 9 серпня · 14:30 - 16:30📍 Hacker Dojo, Mountain View
Місце проведення
Розкажіть своїй мережі, що ви йдете
Поділіться цією подією, щоб розпочати розмови, запросити колег та налагодити контакти до її початку.
Подібні події

Осінній симпозіум кар'єри в районі затоки 2026 року
Big Swings & Hot Takes: AI, Dev & Security Meetup
AI Trading: The Next Edge
AI/Tech Founders, Builders & VC Mixer | NYU CEC
Нова Ренесанса (з The AI Collective)
Yale AI Association Autumn Launch (brought to you by SpaceXAI) - LIMITED Capacity :)
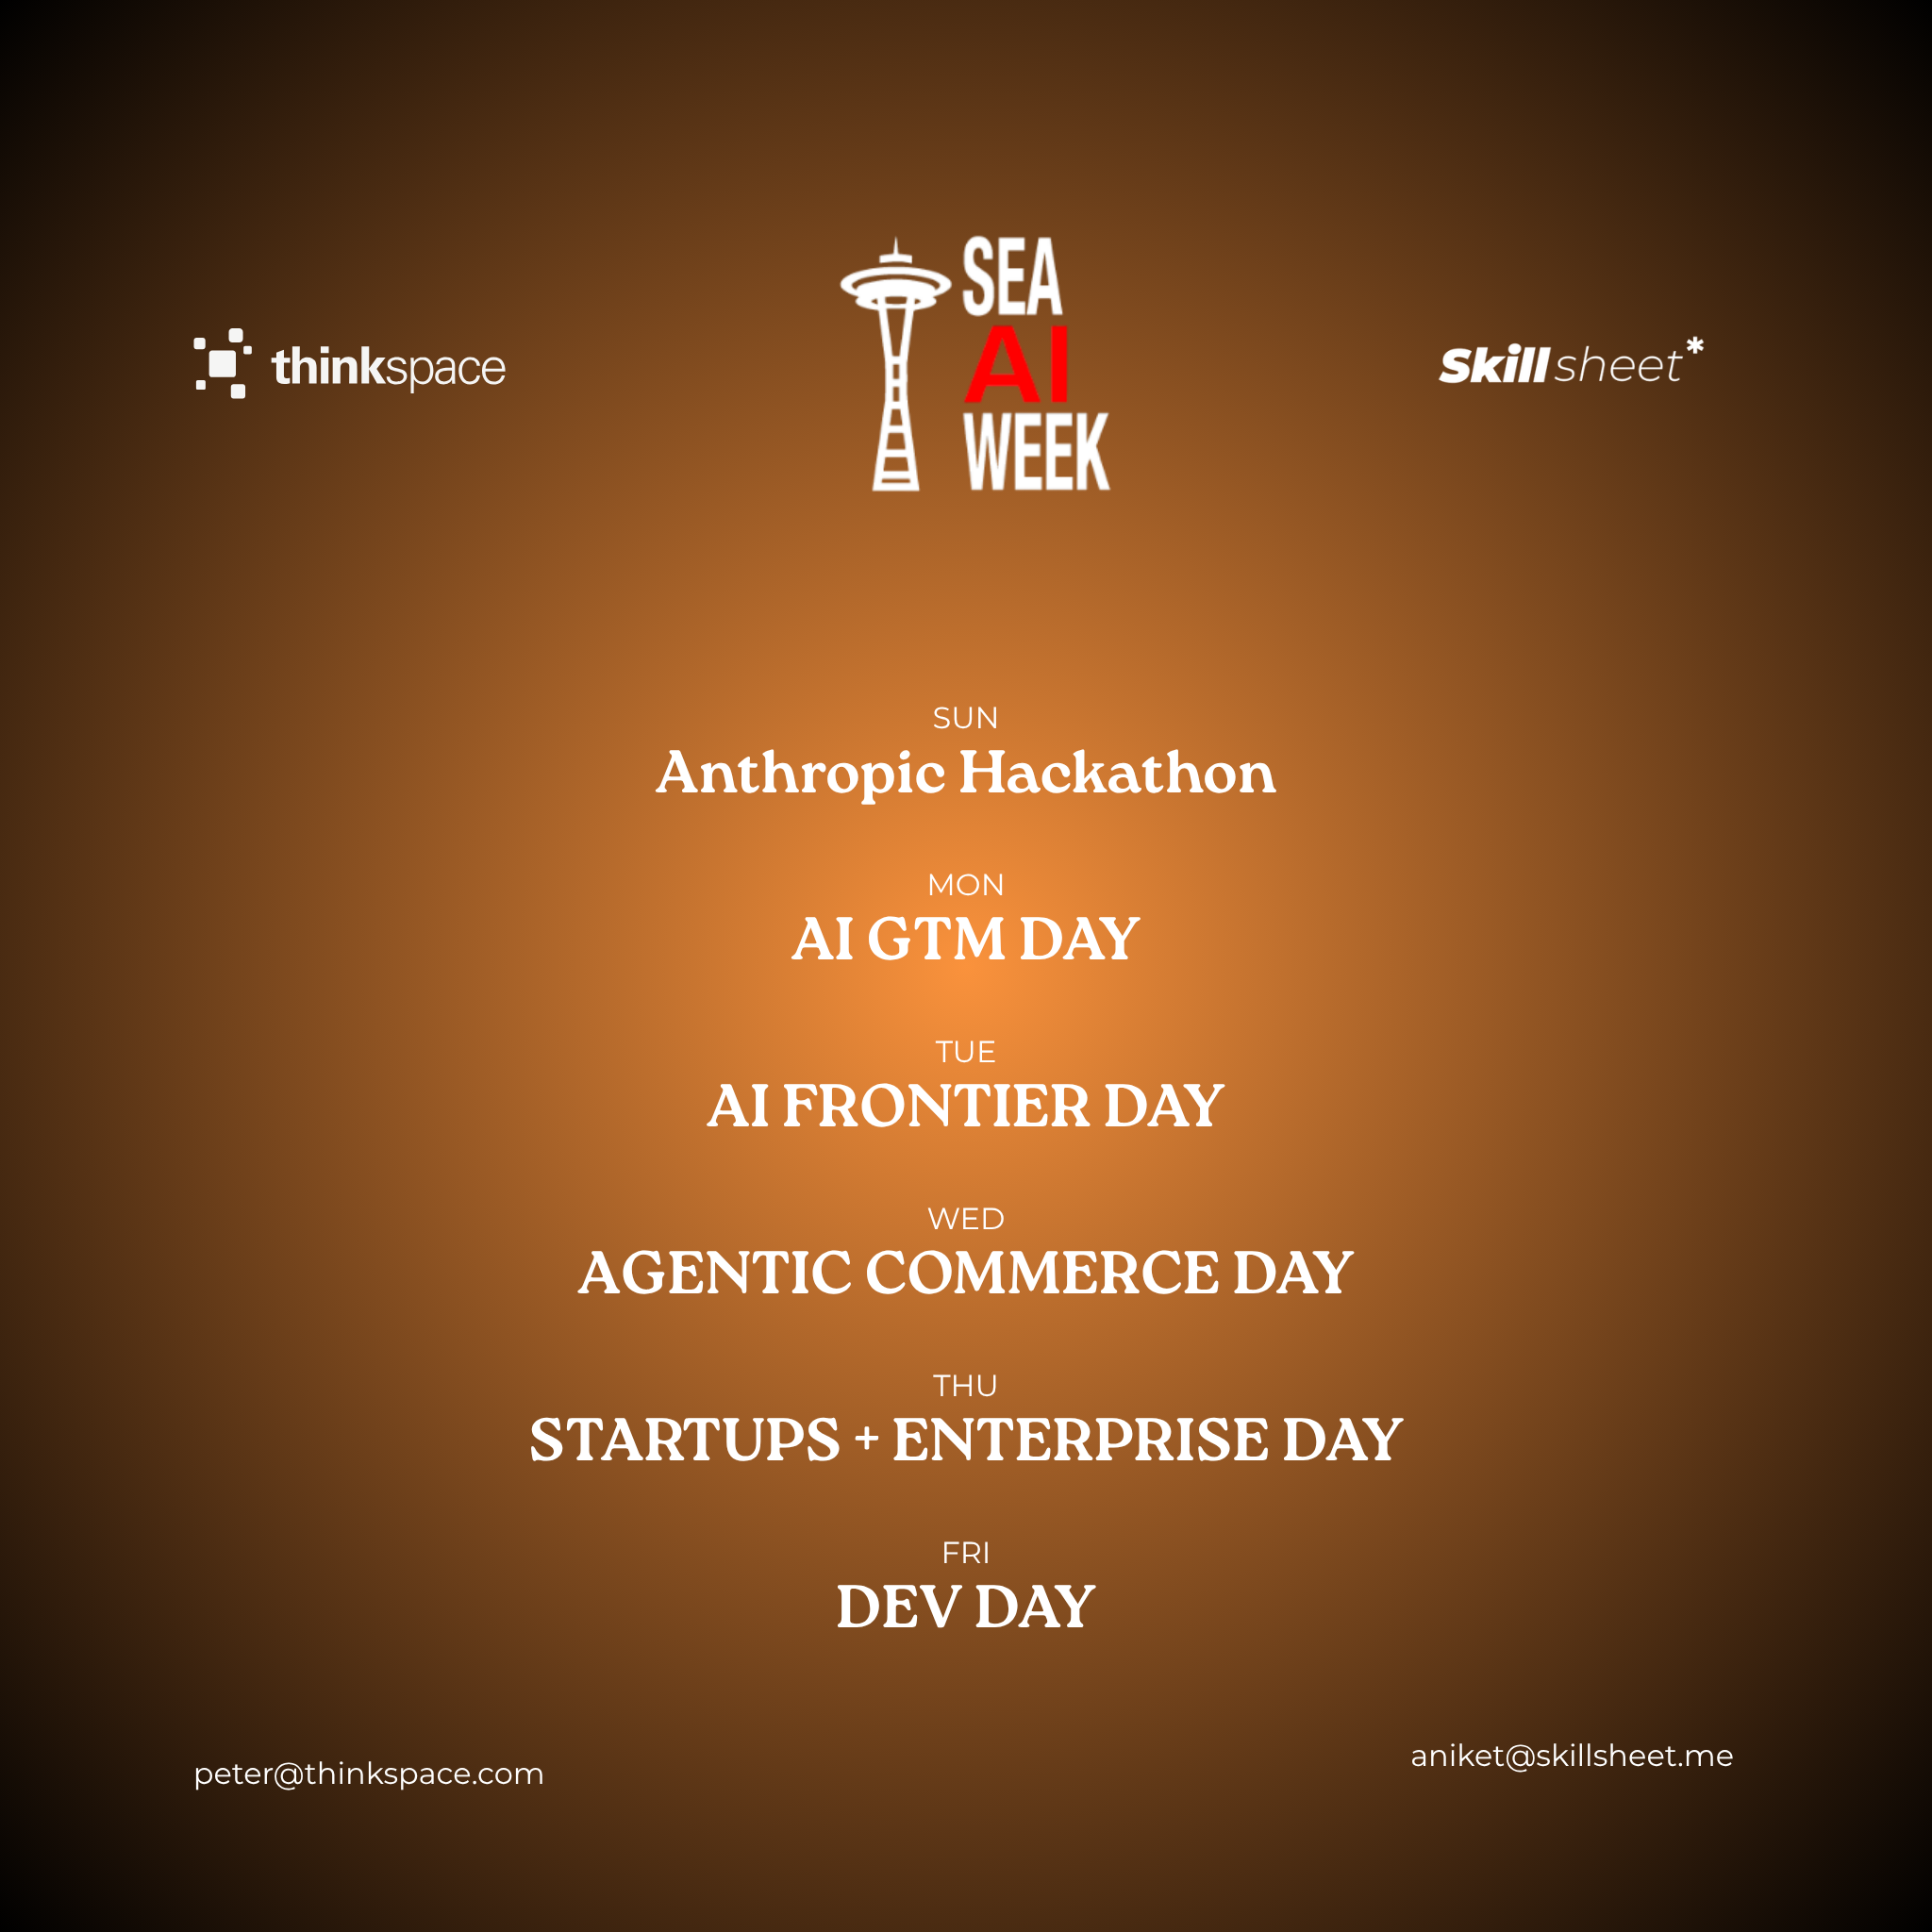
[SEA AI WEEK] Anthropic Hackathon