
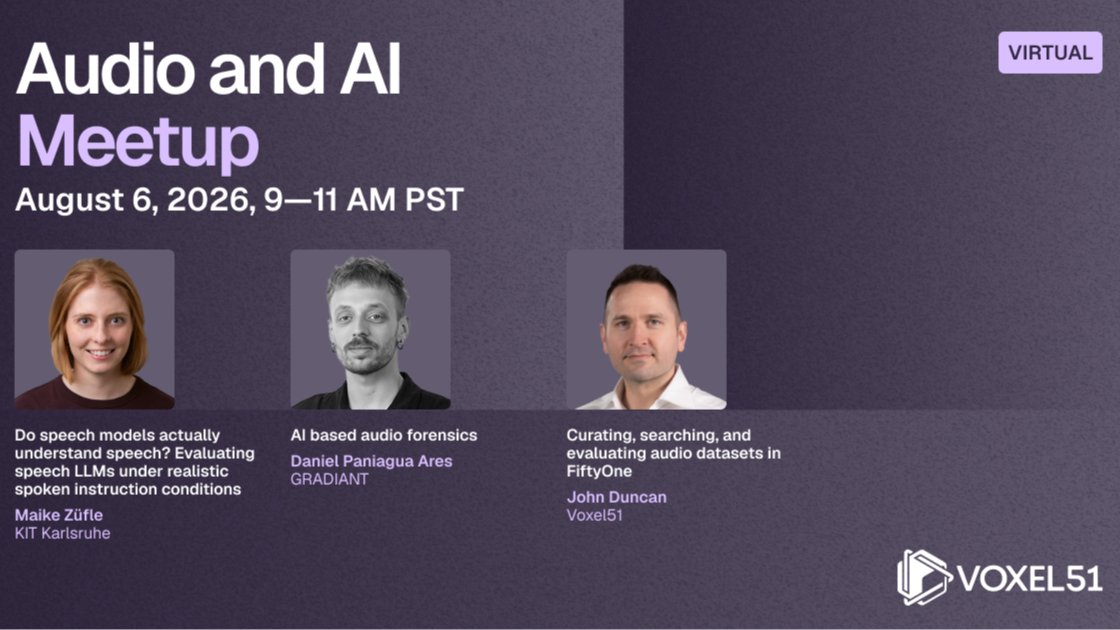
6 sierpnia - Spotkanie Audio i AI
Opis
Dołącz do naszego wirtualnego spotkania, aby wysłuchać wystąpień ekspertów na temat najnowszych zagadnień związanych z AI, ML i wizją komputerową. Data, czas i lokalizacja 6 sierpnia 2026 9:00 - 11:00 PST Online. Zarejestruj się na Zoom! Czy modele mowy rzeczywiście rozumieją mowę? Ocena modeli dużych języków mowy w realistycznych warunkach instrukcji mówionej Modele dużych języków mowy (SLLMs) stają się coraz bardziej zdolne; ale czy oceniamy je we właściwy sposób? Większość benchmarków opiera się na podpowiedziach tekstowych, podczas gdy prawdziwi użytkownicy interaktywują z tymi systemami za pomocą mowy, co wprowadza szumy, niepłynności i różnorodność stylistyczną, której tekst po prostu nie uchwyca. W tym wykładzie przedstawiamy wyniki systematycznego badania w 11 zadaniach, 12 językach i pięciu stylach podpowiedzi, analizując, jak rodzaj podpowiedzi, język i typ zadania kształtują wyniki SLLM. O prelegencie Maike Züfle jest studentką doktorancką w Karlsruhe Institute of Technology (KIT), pracującą w grupie prof. Jana Niehuesa nad interaktywnymi systemami mowy dla bardziej naturalnej komunikacji człowiek-maszyna. Jej badania koncentrują się na modelach mowy, które wykonują polecenia, przyjmując mowę zarówno jako wejście, jak i wyjście, z ostatnim naciskiem na systemy pełnodupleksowe. Poza swoimi badaniami współorganizuje zadania związane z metrykami do wykonywania instrukcji i tłumaczenia mowy na IWSLT. Jest stypendystką Apple Scholar w AI/ML w 2026 roku. Audiozabezpieczenia oparte na AI Podczas tej prezentacji uczestnicy odkryją kilka modułów opracowanych przez Gradiant w celu wykrywania i analizy syntetycznie generowanego lub zmanipulowanego audio. Sesja będzie prowadzona przez jednego z deweloperów zaangażowanych w projektowanie i wdrażanie tych technologii, oferując wgląd w ich możliwości i podstawową metodologię. Prezentacja obejmie moduł śledzenia, który pomaga zidentyfikować pochodzenie treści generowanych przez AI. Obejmuje również narzędzie do wykrywania segmentów, zaprojektowane do lokalizowania zmanipulowanych obszarów w nagraniu audio, a także pełne narzędzie do wykrywania audio, które ocenia, czy całe nagranie zostało syntetycznie wygenerowane. O prelegencie Daniel Paniagua Ares jest inżynierem badawczym w Gradiant. Ukończył inżynierię komputerową na FIC oraz uzyskał tytuł magistra w dziedzinie AI na VIU. Kuracja, wyszukiwanie i ocena zbiorów danych audio w FiftyOne W tym wykładzie zaczniemy od zestawu danych dźwiękowych ESC-50, aby pokazać, jak FiftyOne przedstawia audio: przeglądanie klipów w widoku tabeli, renderowanie spektrogramów bezpośrednio w siatce próbek za pomocą niestandardowego renderera oraz przekształcanie dźwięków w wektory, które można wyszukiwać za pomocą osadzania CLAP. Następnie zaprezentujemy panel wyszukiwania podobieństw, który pozwala na zadawanie zapytań do całej kolekcji audio na podstawie przykładowego klipu lub naturalnego zapytania, aby szybko znaleźć dopasowane dźwięki. Na koniec zajmiemy się żywym problemem badawczym: Wydobycie Momentu Audio z Wyzwania DCASE 2026, którego celem jest lokalizacja dokładnego momentu w długim nagraniu, który odpowiada zapytaniu tekstowemu. Ujęcie tego jako detekcji czasowej, ocena prognoz i wizualizacja prawdy w gruntach w porównaniu z prognozowanymi momentami na interaktywnej osi czasu, aby intuicyjnie ujawnić tryby błędów modelu. Uczestnicy opuszczą spotkanie z konkretnym planem działania i otwartym kodem do zastosowania praktyk opartych na danych w ich własnych złożonych zbiorach danych audio i multimodalnych. O prelegencie John Duncan jest inżynierem uczenia maszynowego w Voxel51. Jego zainteresowania badawcze obejmują wizję, LiDAR i percepcję audio dla robotów i inteligentnych systemów.
Lokalizacja wydarzenia
Daj swojej sieci znać, że idziesz
Udostępnij to wydarzenie, aby rozpocząć rozmowy, zaprosić kolegów i nawiązać kontakty przed jego rozpoczęciem.
Powiązane wydarzenia

Stop Building AI Agents – Start Building AI SKILLS. A Complete TutorialWed, Jul 1 · 5:30 PM EDTby Tampa Bay Biotechicon 5.
UX-Ai Collab: meetup
Community Round Table: AI, Agents, Skills and MCP | DenverScript June 2026
AI Meetup (July): GenAI LLMs and Agents
Streaming/ Tribe #26 - Le startup possono diventare autonome grazie all’AI?
Building an AI-Enabled BusinessTue, Jun 23 · 5:30 PM EDTby Entrepreneurs Learning & Growth Hubicon 4.
Summer AI Study Group Series Kick Off
Ai Engineering primer
7 seats leftAI Happy HourTue, Jun 23 · 7:00 PM EDTby AI Club3 attendees
The AI Underground - Conference
AI think tank. Learn to make money with AI