24 sept. - Meetup sur l'IA, le ML et la vision par ordinateur
Description
Rejoignez notre meetup virtuel le 24 septembre pour écouter des conférences d'experts sur des sujets de pointe en IA, ML et vision par ordinateur. Date, Heure et Lieu 24 sept. 2026 9h00 - 11h00 PST En ligne. Inscrivez-vous pour le Zoom ! Comment les principes de l'IA de Mercedes-Benz guident notre innovation ? Chez Mercedes-Benz, nos principes d'IA guident chaque étape de l'innovation, en mettant l'accent sur une utilisation responsable, la sécurité et la fiabilité, l'explicabilité et la protection de la vie privée. Ces principes vont au-delà des déclarations et façonnent activement la manière dont nous concevons, testons et déployons des systèmes d'IA dans des environnements automobiles et d'entreprise réels. Dans cette conférence, je présenterai comment ces principes ont inspiré nos recherches récentes sur l'efficacité de la réutilisation de LoRA (Low-Rank Adaptation). En combinant une analyse théorique avec des données synthétiques comme proxy pour des scénarios d'entreprise, nous avons découvert les forces et les limites des composants d'IA modulaires sous un accès de données contraint. Nos conclusions fournissent des conseils pratiques sur quand les LoRA réutilisés pourraient offrir des résultats de haute qualité. À propos de l'intervenante Mei-Yen Chen est une scientifique des données senior chez Mercedes-Benz Tech Innovation GmbH en Allemagne, avec 10 ans d'expérience dans l'industrie en IA et solutions de données. Elle dirige des projets d'IA en phase précoce à travers des fonctions commerciales et collabore avec des institutions de recherche sur l'apprentissage machine et l'IA responsable. Les tokens régionaux comme primitive visuelle : De la reconnaissance à la modélisation du monde La tokenisation basée sur des patches est devenue l'interface par défaut entre les encodeurs visuels et les modèles en aval, pourtant les patches n'ont aucune structure sémantique et évoluent mal avec la résolution et l'ampleur temporelle. Cette conférence présente un programme de recherche centré sur le remplacement des tokens de patch par des représentations au niveau régional — des tokens sémantiquement denses ancrés dans des entités visuelles plutôt que dans des découpes de grille arbitraires. Je vais décrire RELOCATE, REN et T-REN, une progression de méthodes qui produisent des tokens régionaux via le pooling, les forment avec des objectifs au niveau régional, et les étendent à la vidéo avec une cohérence temporelle. Je présenterai ensuite des travaux en cours intégrant des tokens régionaux dans les VLM pour élargir directement la capacité de contexte visuel, et des résultats préliminaires sur la prédiction de trajectoire régionale future comme base pour la modélisation du monde. La thèse plus large est que les tokens au niveau régional sont une unité de calcul visuel plus naturelle que les patches, et leur avantage se cumule à mesure que la complexité des tâches, la résolution et l'horizon temporel augmentent. À propos de l'intervenant Savya Khosla est doctorant en deuxième année à l'Université de l'Illinois Urbana-Champaign, conseillé par le Prof. Derek Hoiem et le Prof. Alex Schwing. Exploitation des modèles de diffusion texte-à-image pour une génération cohérente de set-à-set Les collections d'images sont le principal moyen par lequel les humains capturent le monde, pourtant les avancées dans l'édition générative restent largement inapplicables à cette modalité. Nous abordons cette lacune en introduisant Match-and-Fuse - une méthode zéro-shot, sans formation pour la génération cohérente de set-à-set à partir de collections d'images partageant un élément visuel commun mais différant en angle de vue, temps de capture et contenu environnant. Notre idée clé est un cadre unifié basé sur des graphes qui combine des correspondances denses avec un prior émergent dans les modèles de diffusion texte-à-image pour générer des toiles cohérentes. Nous atteignons une cohérence et une qualité visuelle à la pointe de l'état de l'art, et déverrouillons de nouvelles capacités créatives pour la génération de contenu. À propos de l'intervenante Kate Feingold est doctorante en Vision par Ordinateur à l'Institut Weizmann des Sciences. Ses recherches se situent à l'intersection des modèles génératifs, de la perception 3D/4D et de l'apprentissage multimodal, se concentrant sur des problèmes où la vision rencontre d'autres modalités ou paradigmes dans des tâches créatives. Estimation du rendement d'un café dans un environnement dense Cette présentation fournit un flux de travail détaillé relatif à l'estimation du rendement du café dans un environnement dense. Avec des photos de plants de café avant récolte provenant de plusieurs domaines caféiers, des détails liés au prétraitement, à l'annotation pour détecter les régions d'intérêt (ROI), à l'entraînement de détection d'objets et aux résultats d'inférence avec divers modèles Yolo, et enfin à la segmentation avec SAM2 et Yolo*-seg avec des résultats d'entraînement et d'inférence pour déterminer le nombre de baies de café crues, prématurées, matures et surmatures et enfin le rendement de l'ensemble de la propriété. Tout cela est basé sur des données du monde réel capturées sur des iPhones et des téléphones Android. À propos de l'intervenant Raghu M. Rao est consultant travaillant sur des applications de modèles d'IA de vision par ordinateur. Il a précédemment travaillé chez AMD et Xilinx. Il détient un doctorat en communication sans fil de l'UCLA et est membre senior de l'IEEE. Ses intérêts actuels portent sur les applications de l'IA pour l'agriculture, les soins de santé et les communications sans fil.
Faites savoir à votre réseau que vous y allez
Partagez cet événement pour engager des conversations, inviter des collègues et vous connecter avant qu`il commence.
Événements similaires
Construisez ce que vous imaginez : Création d'applications alimentées par l'IA avec Base44
Atelier No-Code : Créez votre Premier Site Web avec l'IA 👾
L'IA dans la salle de classe
Table Ronde Hebdomadaire : Votre contenu ressemble à celui écrit par une IA.
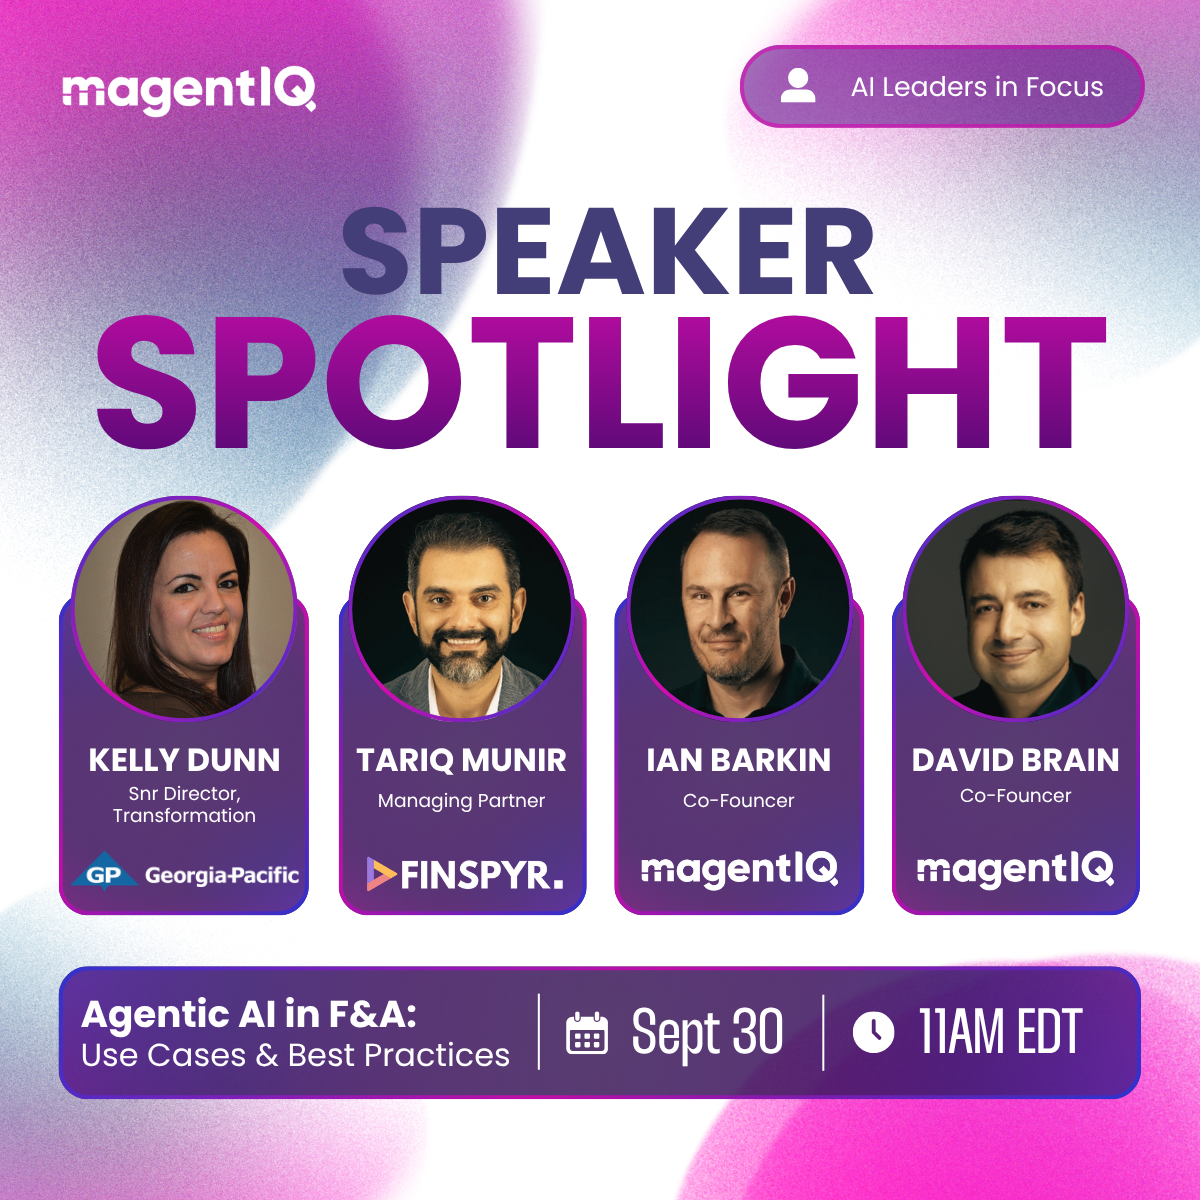
IA agentique dans la finance et la comptabilité : cas d'utilisation et meilleures pratiques
Bittensor Inde : Appel communautaire de septembre 🇮🇳
Codage Vibe pour les Entreprises : Comment codifier des applications de manière sécurisée et gouvernée