
Club de Lecture de Papiers Layer Learning - Semaine 33 - SlopCodeBench
Description
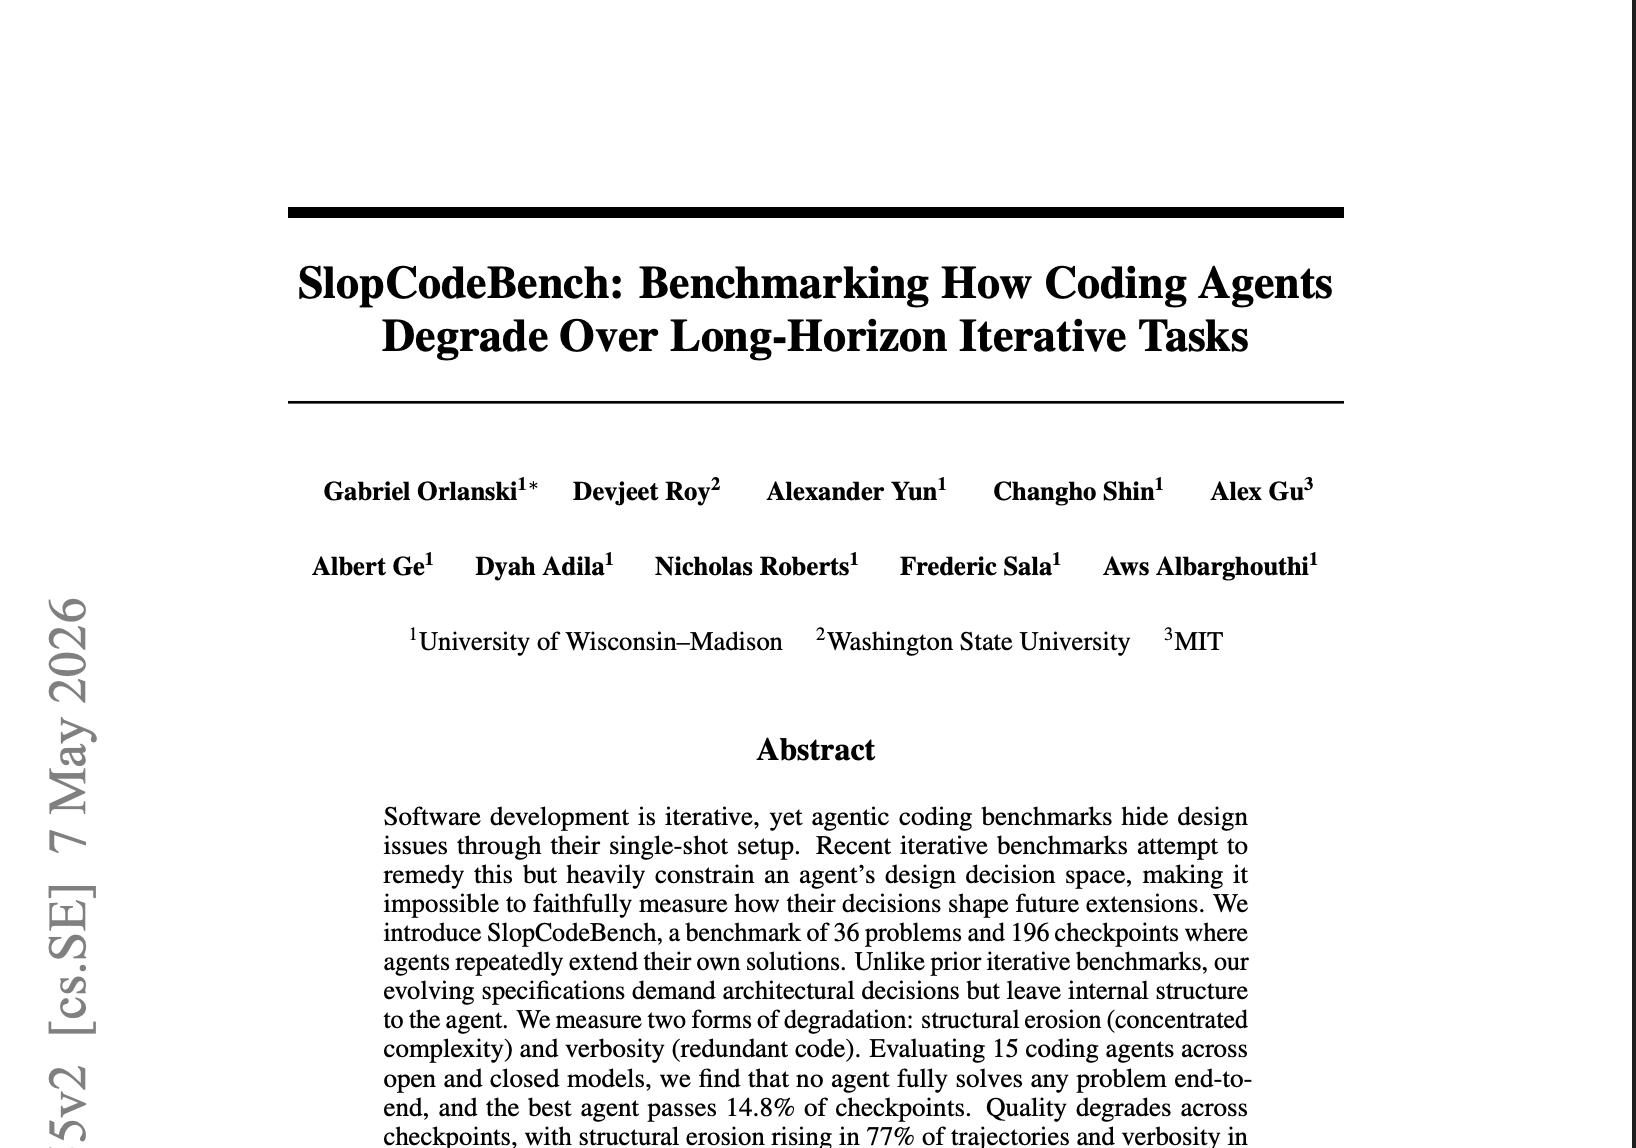
Le papier de cette semaine:SlopCodeBench: Évaluation de la manière dont les agents de codage se dégradent au fil de tâches itératives à long terme Lien: https://arxiv.org/abs/2603.24755Site: https://www.scbench.ai/Code: https://github.com/SprocketLab/slop-code-bench Résumé: Presque chaque benchmark de codage demande à un agent de résoudre un problème une fois, depuis le début. Le véritable logiciel n'est pas construit de cette manière — il est prolongé, encore et encore, par quelqu'un travaillant sur du code qui existe déjà. Une configuration à tir unique cache ce dont se soucient réellement les praticiens : non pas si un agent peut réussir un test aujourd'hui, mais à quoi ressemble son code après vingt rounds de "gère maintenant aussi cela." SlopCodeBench mesure cela. C'est un benchmark de 36 problèmes et 196 points de contrôle dans lequel un agent prolonge en continu sa propre solution antérieure à mesure que de nouvelles exigences arrivent. Les spécifications décrivent délibérément seulement le comportement externe — un contrat CLI ou API — et ne disent rien sur l'architecture, les signatures de fonction ou les limites de module, donc les décisions de conception initiales sont propres à l'agent et s'accumulent au cours de l'exécution. La suite de tests reste cachée afin qu'elle ne puisse pas divulguer d'indices structurels. En plus de la correction, les auteurs suivent deux formes de dégradation : l'érosion structurelle (la complexité se concentrant dans des fonctions déjà complexes) et la verbosité (croissance du code redondant et dupliqué). Les résultats sont sombres. Parmi 15 agents de codage ouverts et fermés, aucun ne résout intégralement un seul problème de bout en bout, et le meilleur en réussit 14,8 % des points de contrôle. La qualité diminue à mesure que les trajectoires s’allongent : l'érosion structurelle augmente dans 77 % des exécutions et la verbosité dans 75,5 %. La comparaison qui donne son nom au papier : mesurée par rapport à 473 dépôts Python open-source, le code des agents est 2,3 fois plus verbeux et 2,0 fois plus érodé, et les dépôts humains se dégradent moins souvent et par des marges plus petites à travers leurs historiques Git. Dire explicitement à l'agent d'écrire un code propre réduit la verbosité initiale et l'érosion jusqu'à un tiers — mais ne change rien au taux de dégradation. Pertinent pour quiconque expédie du code avec un agent dans le processus, et pour quiconque réfléchissant à la manière d'évaluer un comportement agentique à long terme. Aucune préparation requise — venez lire et discuter avec nous. Jason Carver présentera le papier cette semaine Qu'est-ce que le Club de Lecture de Papiers des Learning Layer Labs ? Une initiative de https://www.learninglayer.ai, un laboratoire avec pour objectif de réduire l'anxiété liée à l'IA dans le monde. Quel est le format ? Basé sur la discussion. Attendez-vous à un environnement sans pression pour partager des idées et des opinions avec le groupe. Quels sont les objectifs du groupe ? Rester à jour sur la recherche en IA et améliorer la compréhension des fondamentaux de l'IA + des mathématiques. Qui est le bienvenu ? Tout le monde ! Essayez de consacrer au moins un peu de temps au papier et venez préparé avec des questions ou des choses que vous aimeriez discuter, mais il est tout à fait acceptable de simplement se présenter ! Équipe des Learning Layer Labs :
Lieu de l`événement
Faites savoir à votre réseau que vous y allez
Partagez cet événement pour engager des conversations, inviter des collègues et vous connecter avant qu`il commence.
Événements similaires

Arrêtez de créer des agents IA – Commencez à développer des COMPÉTENCES IA. Un tutoriel complet, mer. 1er juillet · 17h30 HAE par Tampa Bay Biotechicon.
Collab UX-Ai : rencontre
Table ronde communautaire : IA, agents, compétences et MCP | DenverScript juin 2026
Rencontre IA (juillet) : GenAI LLMs et agents
Streaming/ Tribe #26 - Les startups peuvent-elles devenir autonomes grâce à l'IA ?
Construire une entreprise dotée d'une IA Mardi 23 juin · 17h30 EDT par Entrepreneurs Learning & Growth Hub.
Lancement de la série d'études estivales sur l'IA
Introduction à l'ingénierie de l'IA
7 places restantes AI Happy Hour Mar, 23 juin · 19:00 EDT par AI Club 3 participants
La Conférence de l'Intelligence Artificielle Souterraine
Groupe de réflexion sur l'IA. Apprenez à gagner de l'argent avec l'IA