24 de septiembre - Encuentro sobre IA, ML y Visión por Computadora
Descripción
Únete a nuestro encuentro virtual el 24 de septiembre para escuchar charlas de expertos sobre temas de vanguardia en IA, ML y visión por computadora. Fecha, Hora y Ubicación 24 de septiembre de 2026, 9:00 AM - 11:00 AM PST En línea. ¡Regístrate para el Zoom! ¿Cómo impulsan nuestros principios de IA de Mercedes-Benz nuestra innovación? En Mercedes-Benz, nuestros principios de IA guían cada paso de la innovación, enfatizando el uso responsable, la seguridad y la fiabilidad, la explicabilidad y la protección de la privacidad. Estos principios van más allá de las declaraciones y moldean activamente cómo diseñamos, probamos y desplegamos sistemas de IA en entornos automotrices y empresariales del mundo real. En esta charla, presentaré cómo estos principios inspiraron nuestra investigación reciente sobre cuándo la reutilización de LoRA (Adaptación de Bajo Rango) es efectiva. Al combinar análisis teóricos con datos sintéticos como un proxy para escenarios empresariales, descubrimos las fortalezas y limitaciones de los componentes de IA modulares bajo acceso a datos restringidos. Nuestros hallazgos proporcionan orientación práctica sobre cuándo los LoRAs reutilizados podrían ofrecer resultados de alta calidad. Acerca de la Ponente Mei-Yen Chen es Científica de Datos Senior en Mercedes-Benz Tech Innovation GmbH en Alemania con 10 años de experiencia en la industria en soluciones de IA y datos. Ella lidera proyectos de IA en etapa temprana a través de funciones comerciales y colabora con instituciones de investigación en aprendizaje automático e IA responsable. Tokens de Región como el Primitivo Visual: De Reconocimiento a Modelado Mundial La tokenización basada en parches se ha convertido en la interfaz predeterminada entre los codificadores de visión y los modelos posteriores, sin embargo, los parches no tienen estructura semántica y escalan pobremente con la resolución y la extensión temporal. Esta charla presenta un programa de investigación centrado en reemplazar los tokens de parches con representaciones a nivel de región: tokens semánticamente densos basados en entidades visuales en lugar de recortes de cuadrícula arbitrarios. Describiré RELOCATE, REN y T-REN, una progresión de métodos que producen tokens de región a través de agrupamiento, los entrenan con objetivos a nivel de región y los extienden al video con coherencia temporal. Luego presentaré trabajos en curso integrando tokens de región en VLMs para expandir directamente la capacidad de contexto visual, y resultados preliminares sobre predicción de trayectorias de región futura como base para el modelado del mundo. La tesis más amplia es que los tokens a nivel de región son una unidad de cálculo visual más natural que los parches, y su ventaja se acumula a medida que aumenta la complejidad de la tarea, la resolución y el horizonte temporal. Acerca de la Ponente Savya Khosla es estudiante de segundo año de doctorado en la Universidad de Illinois Urbana-Champaign, asesorada por el Prof. Derek Hoiem y el Prof. Alex Schwing. Aprovechando los Modelos de Difusión de Texto a Imagen para Generación Consistente de Conjuntos Las colecciones de imágenes son la forma principal en que los humanos capturan el mundo, sin embargo, los avances en edición generativa siguen siendo en gran medida inaplicables a esta modalidad. Abordamos esta brecha introduciendo Match-and-Fuse: un método sin entrenamiento y en cero disparos para la generación consistente de conjuntos a partir de colecciones de imágenes que comparten un elemento visual común pero difieren en punto de vista, tiempo de captura y contenido circundante. Nuestra idea clave es un marco unificado basado en gráficos que combina correspondencias densas con un priors emergente en modelos de difusión de texto a imagen para generar lienzos coherentes. Logramos una consistencia y calidad visual de vanguardia, y desbloqueamos nuevas capacidades creativas para la generación de contenido. Acerca de la Ponente Kate Feingold es estudiante de doctorado en Visión por Computadora en el Instituto Weizmann de Ciencia. Su investigación se sitúa en la intersección de modelos generativos, percepción 3D/4D y aprendizaje multimodal, enfocándose en problemas donde la visión se encuentra con otras modalidades o paradigmas en tareas creativas. Estimación de Rendimiento de un Café en un Entorno Denso Esta presentación proporciona un flujo de trabajo detallado relacionado con la estimación de rendimiento de café en un entorno denso. Con fotos de plantas de café antes de la cosecha de un par de fincas de café, detalles relacionados con el pre-procesamiento, anotación para detectar regiones de interés (ROI), entrenamiento de detección de objetos y resultados de inferencia con varios modelos Yolo y finalmente segmentación con SAM2 y Yolo*-seg con resultados de entrenamiento e inferencia para determinar el conteo de bayas de café crudas, prematuras, maduras y sobre-maduras y finalmente el rendimiento de toda la finca. Todo esto se basa en datos del mundo real capturados en iPhone y teléfonos Android. Acerca del Ponente Raghu M. Rao es consultor trabajando en aplicaciones de modelos de IA de visión por computadora. Anteriormente estuvo en AMD y Xilinx. Tiene un doctorado en Comunicaciones Inalámbricas de UCLA y es Miembro Senior de IEEE. Sus intereses actuales son en aplicaciones de IA para la agricultura, la atención médica y las comunicaciones inalámbricas.
Dile a tu red que vas a ir
Comparte este evento para iniciar conversaciones, invitar colegas y conectar antes de que comience.
Eventos relacionados
Crea Lo Que Imaginas: Construcción de Aplicaciones Impulsada por IA con Base44
Taller Sin Código: Crea tu Primer Sitio Web con IA 👾
IA en el Aula
Mesa Redonda Semanal: Tu contenido suena como si lo hubiera escrito una IA.
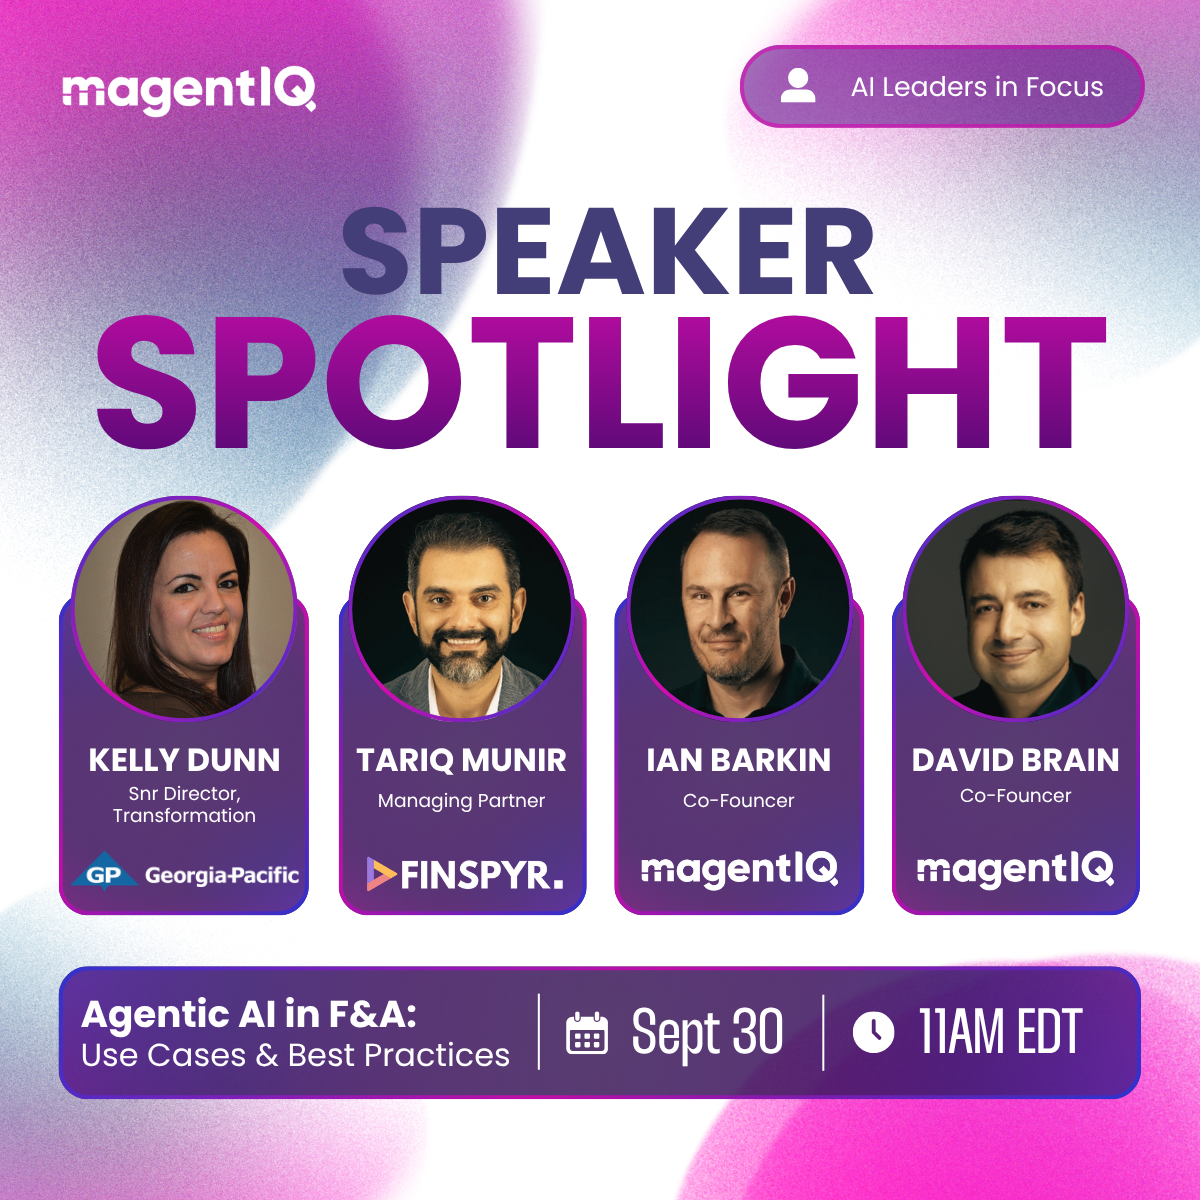
IA Agente en Finanzas y Contabilidad: Casos de Uso y Mejores Prácticas
Bittensor India: Llamada Comunitaria de Septiembre 🇮🇳
Vibe Coding para Empresas: Cómo crear aplicaciones de vibecode de forma segura y gobernada