
Club de Lectura de Artículos de Learning Layer - Semana 33 - SlopCodeBench
Descripción
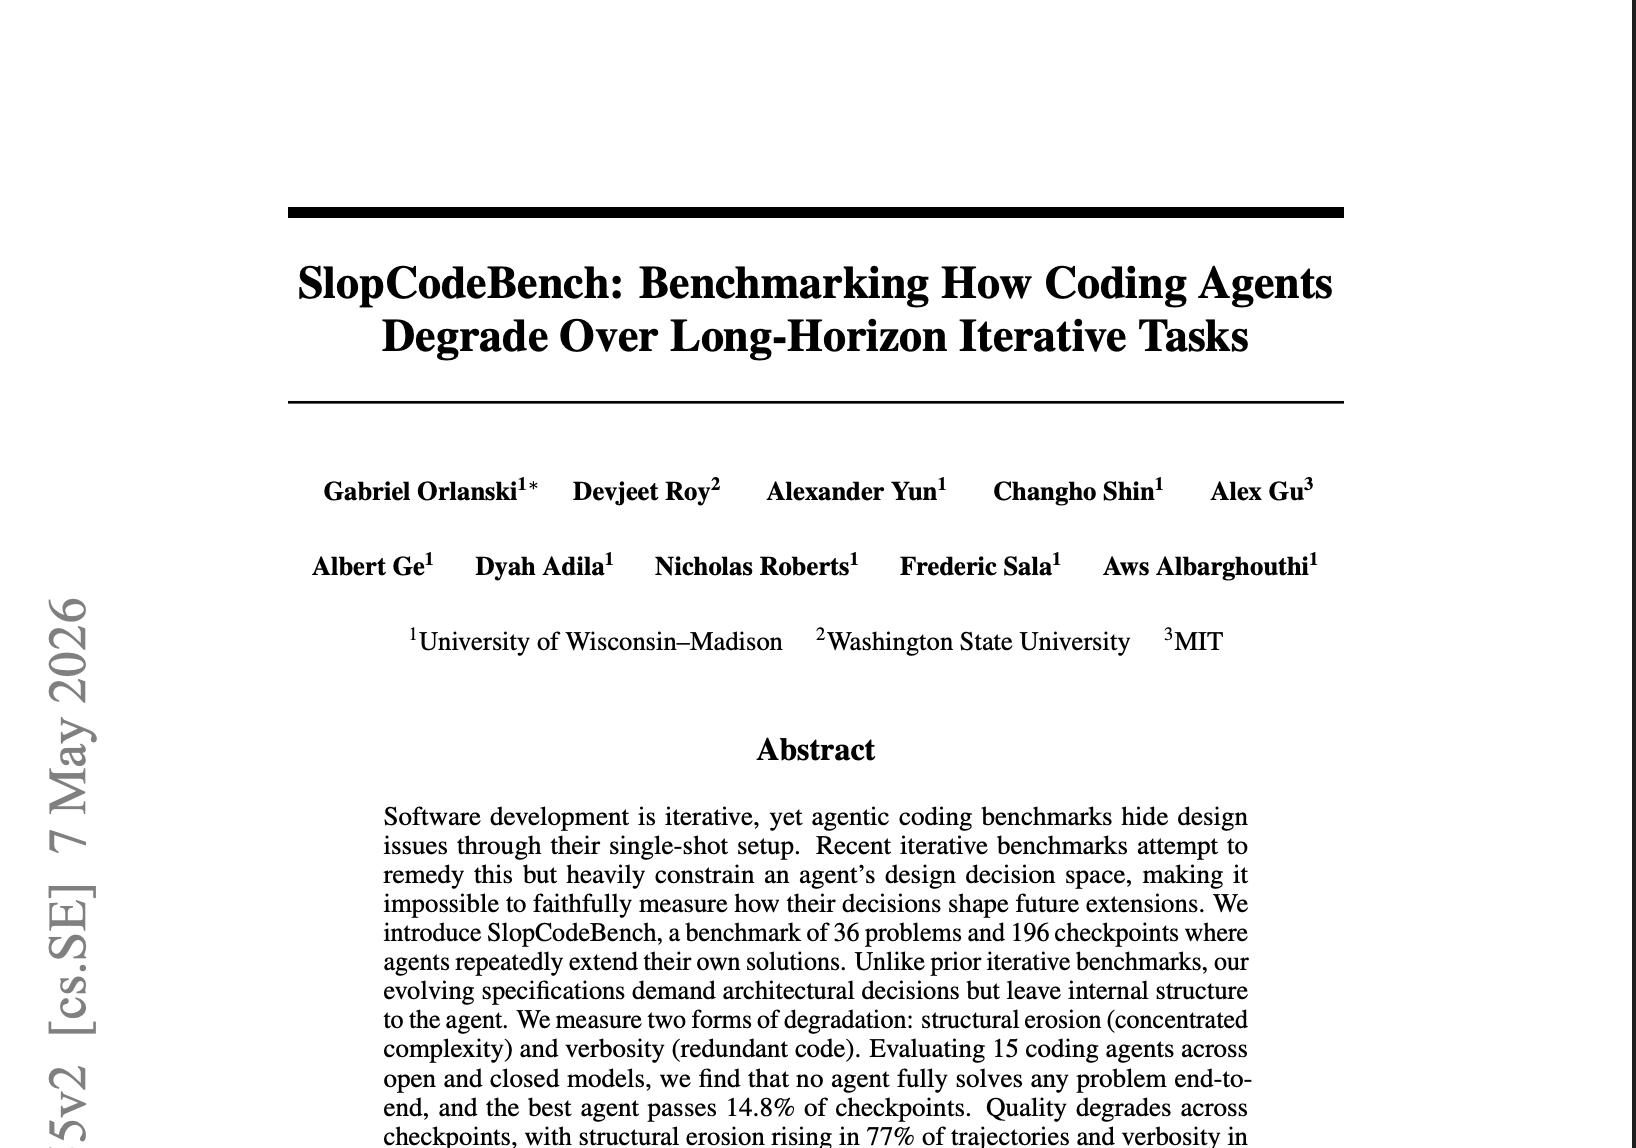
El artículo de esta semana:SlopCodeBench: Evaluación de cómo los agentes de codificación se degradan en tareas iterativas de largo plazo Enlace: https://arxiv.org/abs/2603.24755Sitio: https://www.scbench.ai/Código: https://github.com/SprocketLab/slop-code-bench Resumen: Casi todos los benchmarks de codificación piden a un agente que resuelva un problema una vez, desde cero. El software real no se construye de esa manera: se extiende, una y otra vez, por alguien que trabaja sobre un código que ya existe. Un enfoque de un solo intento oculta lo que realmente preocupa a los practicantes: no si un agente puede pasar una prueba hoy, sino cómo se ve su código después de veinte rondas de "ahora también maneja esto". SlopCodeBench mide eso. Es un benchmark de 36 problemas y 196 puntos de control en los que un agente extiende repetidamente su propia solución anterior a medida que llegan nuevos requisitos. Las especificaciones describen deliberadamente solo el comportamiento externo — un contrato de CLI o API — y no dicen nada sobre la arquitectura, firmas de funciones o límites de módulos, por lo que las decisiones de diseño iniciales son propias del agente y se acumulan a lo largo de la ejecución. El conjunto de pruebas permanece oculto para que no pueda filtrar pistas estructurales. Junto con la corrección, los autores rastrean dos formas de degradación: erosión estructural (complejidad concentrándose en funciones ya complejas) y verbosidad (crecimiento de código redundante y duplicado). Los resultados son sombríos. A través de 15 agentes de codificación abiertos y cerrados, ninguno resuelve completamente un solo problema de extremo a extremo, y el mejor pasa el 14.8% de los puntos de control. La calidad cae a medida que se alargan las trayectorias: la erosión estructural aumenta en el 77% de las ejecuciones y la verbosidad en el 75.5%. La comparación que da nombre al artículo: medido contra 473 repositorios de Python de código abierto, el código del agente es 2.3x más verboso y 2.0x más erosionado, y los repositorios humanos se degradan menos a menudo y por márgenes más pequeños a lo largo de sus historiales de git. Ordenar explícitamente al agente que escriba código limpio reduce la verbosidad y la erosión inicial en hasta un tercio, pero no hace nada con la tasa de degradación. Relevante para cualquiera que envíe código con un agente en el circuito, y para cualquier persona que esté pensando en cómo evaluar el comportamiento agentico a largo plazo. No se requiere preparación: ven a leer y discutir con nosotros. Jason Carver presentará el artículo esta semana ¿Qué es el Club de Lectura de Artículos de Learning Layer Labs? Una iniciativa de https://www.learninglayer.ai, un laboratorio con el objetivo de reducir la ansiedad por la IA en el mundo. ¿Cuál es el formato? Basado en discusiones. Espera un ambiente de baja presión para compartir ideas y opiniones con el grupo. ¿Cuáles son los objetivos del grupo? Mantenerse al tanto de la investigación en IA y mejorar la comprensión de los fundamentos de la IA + matemáticas. ¿Quién es bienvenido? ¡Todos! Intenta dedicar al menos algo de tiempo al artículo y ven preparado con preguntas o cosas que te gustaría discutir, ¡pero está bien simplemente presentarse! Equipo de Learning Layer Labs:
Ubicación del evento
Dile a tu red que vas a ir
Comparte este evento para iniciar conversaciones, invitar colegas y conectar antes de que comience.
Eventos relacionados

Deja de construir agentes de IA – Comienza a construir HABILIDADES de IA. Un tutorial completo miércoles, 1 de julio · 5:30 PM EDT por Tampa Bay Biotech icono 5.
Colaboración UX-Ai: encuentro
Mesa Redonda Comunitaria: IA, Agentes, Habilidades y MCP | DenverScript Junio 2026
Reunión de AI (julio): LLMs y Agentes de GenAI
Streaming/ Tribu #26 - ¿Las startups pueden volverse autónomas gracias a la IA?
Construyendo un Negocio Impulsado por IA Mar, 23 de junio · 5:30 PM EDT por Hub de Aprendizaje y Crecimiento de Emprendedores icono 4.
Inicio de la Serie de Grupos de Estudio de IA de Verano
Principios de Ingeniería de IA
Quedan 7 asientos Hora Feliz de IA Mar, 23 de junio · 7:00 PM EDT por AI Club 3 asistentes
La Conferencia Subterránea de IA
Think tank de IA. Aprende a ganar dinero con la IA.